Развёртывание модели Hugging Face в продакшене — это десяток решений: подобрать serving-контейнер под архитектуру, уточнить актуальный тег образа для конкретного региона AWS, выбрать тип инстанса под объём памяти модели. Дальше нужно настроить автоскейлинг, чтобы не жечь GPU-часы на простаивающем эндпоинте, и повесить алармы Amazon CloudWatch, которые поймают тихий отказ раньше пользователей. Amazon SageMaker ИИ сворачивает эту работу до нескольких часов, но именно такие структурированные и повторяемые задачи хорошо даются coding-агентам вроде Kiro и Claude Code.
Соблазн описать модель агенту и вернуться к готовому эндпоинту велик. На практике необученный агент принимает неверные решения и выдаёт эндпоинты хрупкие, дорогие или тихо неправильные. Проблема усиливается для новых моделей: их обучающие данные могут не содержать свежих знаний о развёртывании. В тесте AWS агентам Kiro (с Auto или Claude Fable 5) и Claude Code (с Opus 4.8) дали задачу развернуть небольшую модель Qwen/Qwen3-0.6B на real-time эндпоинт, сначала записав план в файл и ведя лог действий. Оба агента изначально выбрали Text Generation Inference (TGI) как serving-контейнер — понятный выбор, потому что TGI годами был дефолтом и обучающие данные полны туториалов с ним. Но доступная в регионе сборка TGI предшествовала архитектуре Qwen3 и не смогла загрузить модель. Эндпоинт не прошёл health-check. Агент поднял версию TGI, развернул снова, снова получил отказ и переключился на vLLM. Это дало несколько неудачных развёртываний, каждое из которых тарифицировало GPU-время, пока запускалось и падало.
| Аспект развёртывания | Агент без навыков | Агент с навыками |
|---|---|---|
| Serving-контейнер | Сначала TGI → отказ health-check → vLLM | vLLM, выбран до создания ресурсов |
| Image URI | Найден методом проб и ошибок | Из каталога AWS DLC, с запасным вариантом при отказе реестра |
| Автоскейлинг | Нет | Target tracking, 1–2 инстанса |
| Мониторинг | Нет | Три аларма CloudWatch (задержка, ошибки, накладные расходы) |
| Документация | README рекомендовал TGI, SageMaker SDK и Python 3.13 | План и скрипты совпадали с тем, что реально запускалось |
| Регион, роль, окружение | Верно по умолчанию | Верно по правилу |
| Удаление | Скрипт, который можно запустить | Запуск с проверкой, что ресурсы исчезли |
Второй запрос провалился тише. Того же агента попросили развернуть мультимодальную mixture-of-experts (MoE) diffusion-модель, выпущенную всего за несколько недель до теста. Агенты подтвердили, что она существует, и снова написали скрипт на TGI — текстовом сервере без бэкенда для дискретно-диффузионной image-text модели. Ничего не упало громко: о проблеме стало бы известно только когда эндпоинт отказался бы подниматься. У обоих запусков одна причина — не хватка фактов о развёртывании, а не сбой рассуждений. Агент хорошо планировал и отлаживал, ему не хватало актуального конкретного знания: свежим моделям Qwen нужен vLLM, у Python 3.13 нет рабочих wheel для большей части ML-стека, образы контейнеров следует брать из опубликованного каталога AWS Deep Learning Containers. Эти знания меняются быстрее, чем обновляются веса моделей, поэтому их вынесли в редактируемые файлы навыков, а не полагаются на то, что последний релиз модели их впитает.
Без навыков агент Kiro и Claude Code выбирали TGI, который не поддерживал архитектуру Qwen3, и развёртывание падало на health-check.
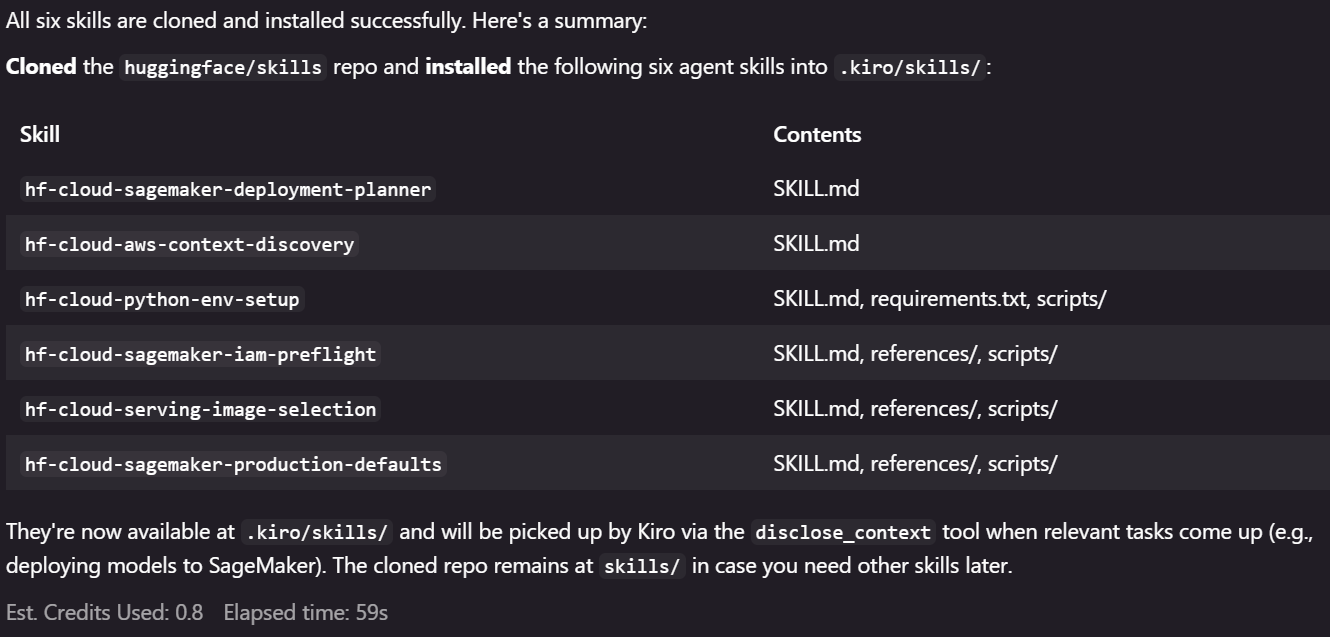
Шесть навыков из репозитория Hugging Face Skills покрывают сквозной цикл развёртывания. Навык hf-cloud-sagemaker-deployment-planner оркестрирует остальные пять и спрашивает только необходимое. hf-cloud-aws-context-discovery обнаруживает локальный контекст AWS. Дальше навыки отвечают за выбор serving-контейнера из каталога AWS DLC, настройку target tracking автоскейлинга на 1–2 инстанса, создание трёх алармов CloudWatch (задержка, ошибки, накладные расходы) и проверяемый путь удаления ресурсов. Real-time эндпоинт — режим по умолчанию, но навыки также поддерживают real-time с scale-to-zero, serverless inference, асинхронный inference, batch transform и Amazon Bedrock Custom Model Import.
Сравнение показывает разницу. Без навыков serving-контейнер выбирается через пробу и ошибку, image URI находится перебором, автоскейлинга и мониторинга нет, а README рекомендует TGI, SageMaker SDK и Python 3.13. С навыками vLLM выбирается до создания любого ресурса, image URI берётся из каталога AWS DLC с запасным вариантом, если запрос к реестру отклонён, появляются target tracking автоскейлинг и три аларма CloudWatch, а план и скрипты совпадают с тем, что реально запускалось. Регион, роль и окружение в обоих случаях верны, но с навыками — по правилу, а не по наитию. Удаление тоже отличается: без навыков это скрипт, который можно запустить, с навыками — запуск с проверкой, что ресурсы исчезли.
Навыки открыты, используют только Python и AWS CLI и работают без изменений на macOS, Linux и Windows. Для команд, которые разворачивают модели Hugging Face на SageMaker ИИ, это способ перенести быстро устаревающие знания о контейнерах, версиях Python и типах инстансов из головы инженера в редактируемые файлы, которые агент читает перед каждым деплоем.