AWS опубликовала разбор того, как выбирать подход к кастомизации генеративного ИИ под конкретную задачу. Материал построен вокруг «спектра кастомизации» — лестницы из восьми шагов, где каждый следующий требует больше усилий, денег и данных, но даёт больше контроля и доменной специфики. Исходная проблема, которую описывает компания, — паралич решений: доступ к Anthropic Claude, Amazon Nova, Llama и Mistral через Amazon Bedrock есть, но неясно, что именно делать с этими моделями под свой сценарий.
Спектр делится на три категории. Первая — USE: модель не трогают, меняют только то, как с ней говорят. Сюда входят шаги 1–2: использование готовой модели как есть и улучшение промптов через системные инструкции, few-shot примеры и chain-of-thought рассуждения. По мере масштабирования с одного промпта до сотен в продакшене AWS предлагает применять оценку промптов по метрикам точности и устойчивости, а также автоматическую оптимизацию, которая переписывает промпты под выбранную модель без ручного перебора.
| Категория | Шаги | Что делают | Что меняется |
|---|---|---|---|
| USE | 1–2 | Использование модели как есть, улучшение промптов | Только способ обращения к модели |
| ENHANCE | 3–5 | RAG, кэширование промптов, дистилляция | Внешние данные и инструменты, веса заморожены |
| TRAIN | 6–8 | Дообучение, continued pre-training, кастомная модель | Веса модели или обучение с нуля |
Вторая категория — ENHANCE: вокруг модели добавляют внешние элементы, веса остаются замороженными. Шаги 3–5 включают RAG для привязки модели к своим документам, кэширование дорогих промптов и дистилляцию знаний большой модели в меньшую и более быструю. AWS описывает это как «использование» модели: обёртка из внешних инструментов, источников данных и оптимизаций без изменения самих весов.
Шаги 1–2 — использование готовых моделей и улучшение промптов через системные инструкции, few-shot примеры и chain-of-thought.
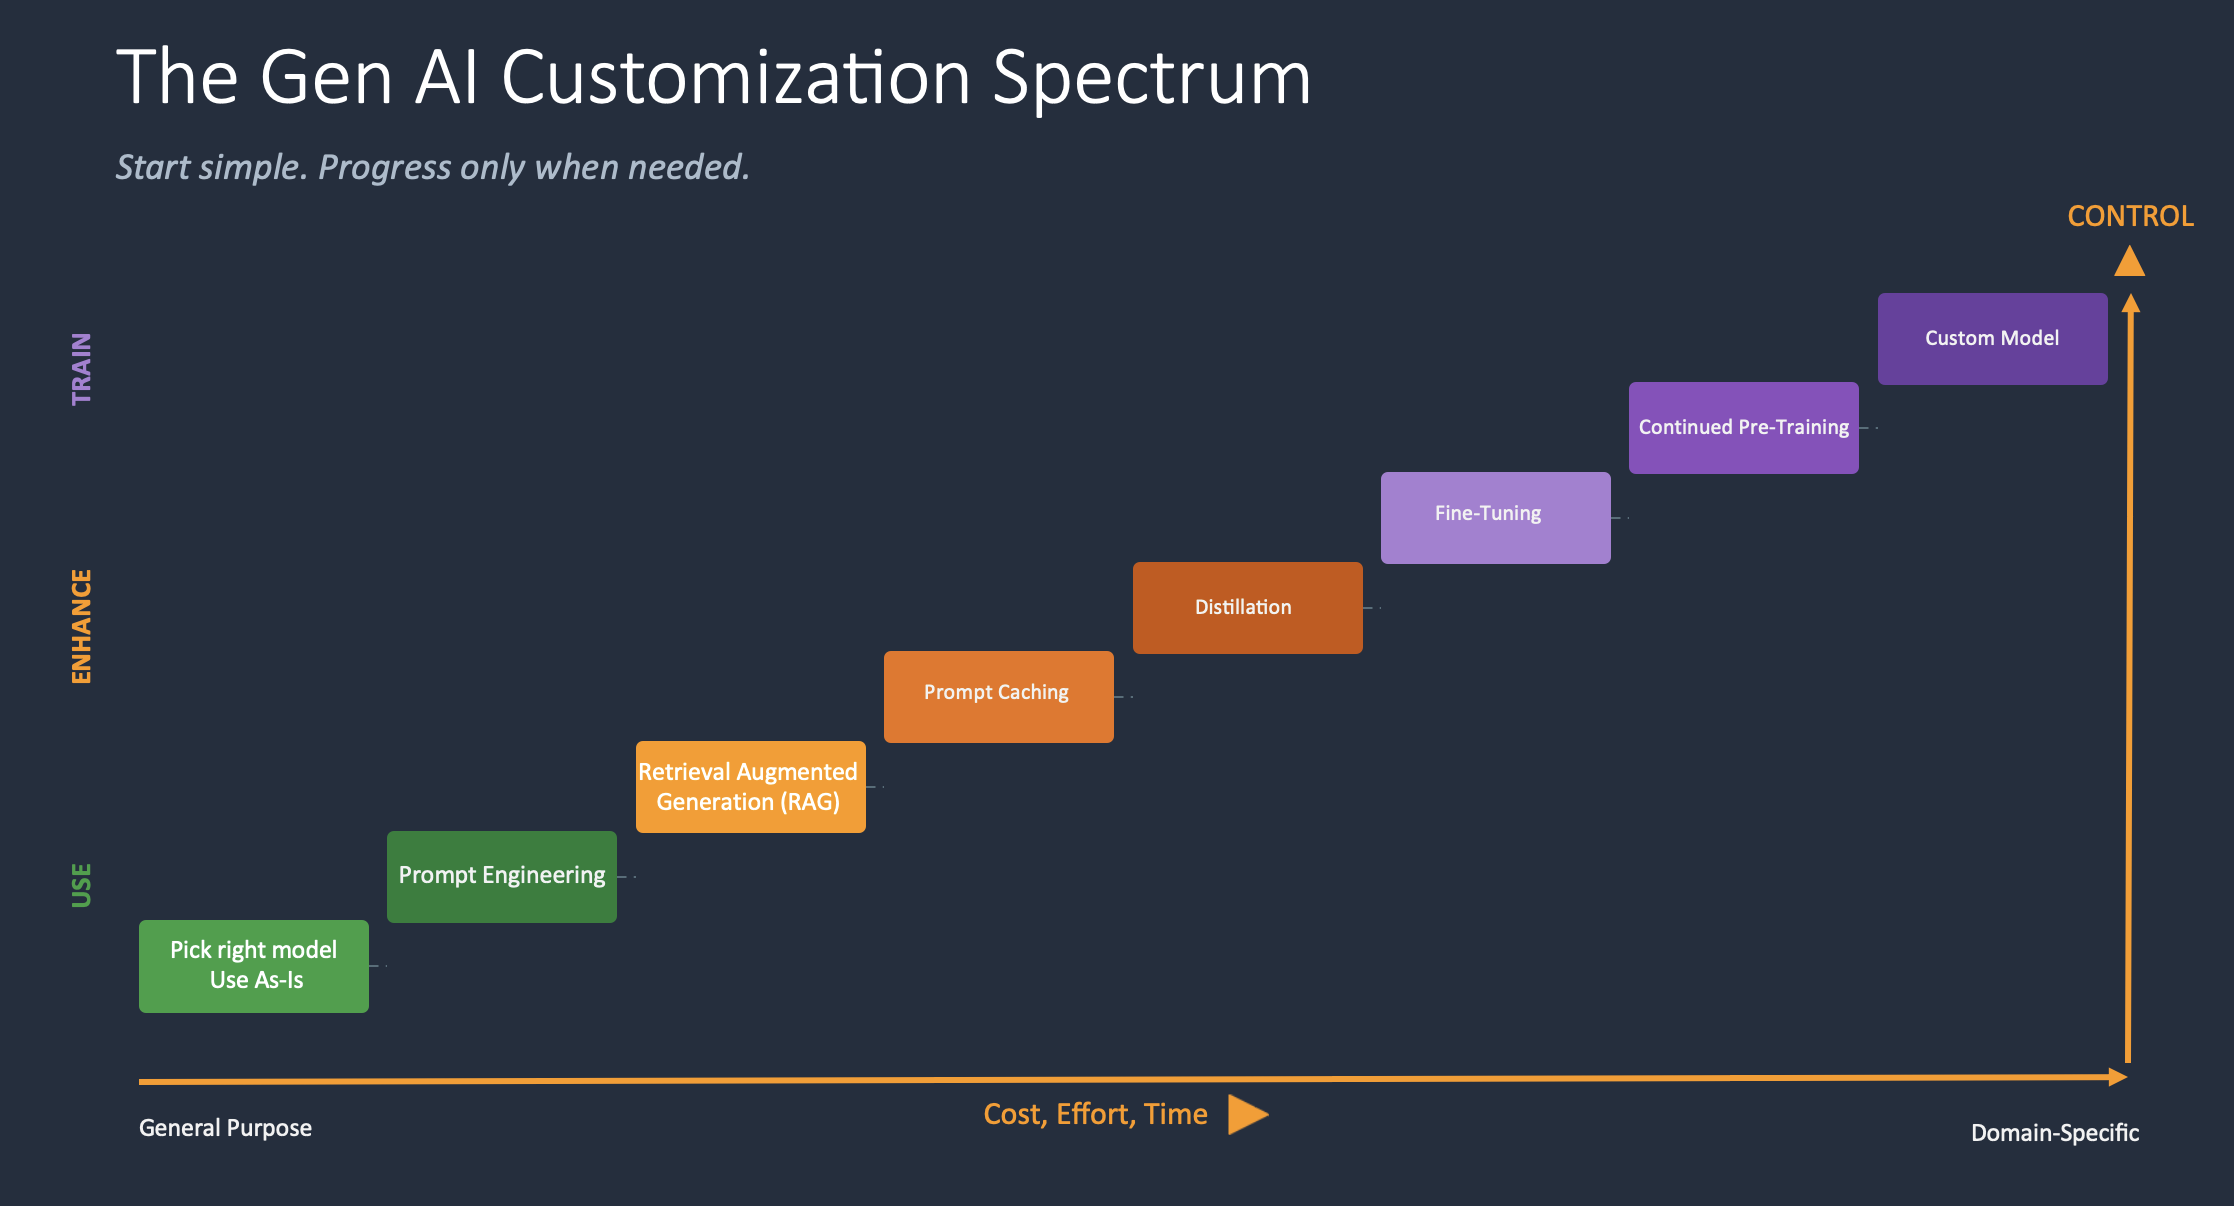
Третья категория — TRAIN: меняют саму модель. Шаги 6–8 — это дообучение на размеченных данных, continued pre-training на больших неразмеченных корпусах для расширения базовых знаний и обучение полностью кастомной модели на Amazon Nova Forge. Правило, которое формулирует AWS: начинать с шага 1 и подниматься выше только тогда, когда текущий шаг не проходит по точности, задержке или требованиям домена. По оценке компании, большинство рабочих нагрузок вообще не выходит за пределы шага 3.
Для наглядности AWS использует аналогию с кухней: модель — это шеф-повар, а шаги — от более чёткого заказа до отправки повара на многомесячное обучение. Дистилляция описана так: дегустационное меню шефа безупречно, но занимает 45 минут на тарелку и стоит целое состояние, поэтому линейного повара учат трём самым продаваемым блюдам — их подают за 10 минут и за треть стоимости. Это прямо отражает компромисс дистилляции: меньшая студенческая модель воспроизводит выходы учителя быстрее и дешевле на тех задачах, которые вы уже проверили.
Практическая ценность материала — в явных сигналах эскалации. AWS описывает типичные ошибки с обеих сторон: одни команды сразу бросаются в дообучение, тогда как хорошо структурированный промпт решил бы задачу за день, другие неделями застревают на промпт-инжиниринге, когда их сценарию явно нужны доменные обучающие данные. Обе ошибки стоят реальных денег на вычислениях, задерживают запуск и бьют по доверию стейкхолдеров, когда выходы модели не оправдывают ожиданий.
Фреймворк привязан к сервисам AWS: Amazon Bedrock даёт доступ к моделям Anthropic, Meta, Mistral и Amazon через единый API, Amazon SageMaker и Amazon Nova Forge закрывают более глубокие шаги. Для читателя, который впервые сталкивается с темой, это означает простую мысль: кастомизация генеративного ИИ — не одна технология, а набор уровней, и выбор уровня важнее выбора конкретной модели.