Amazon Web Services выпустила материал о выборе векторного хранилища для Amazon Bedrock Knowledge Bases. Речь идёт о конфигурации с клиентским управлением, где пользователь сам выбирает бэкенд. Поддерживаются три варианта: Amazon OpenSearch Service, Amazon Aurora PostgreSQL с pgvector и Amazon S3 Vectors. От выбора зависит и скорость ответа, и стоимость решения.
Чтобы понять логику сравнения, нужно разобраться в архитектуре RAG. Retrieval Augmented Generation сочетает возможности больших языковых моделей с системами информационного поиска. Текст переводится в векторы, которые отражают смысл фрагментов. Поиск по векторам находит результаты, близкие по значению к запросу, и это точнее, чем совпадение по ключевым словам. Когда пользователь задаёт вопрос, он тоже превращается в вектор с помощью модели эмбеддингов. Векторная база, где документы заранее разбиты на части и сохранены как эмбеддинги, выполняет поиск похожих фрагментов. Обычно система извлекает top n чанков, например пять самых близких, и передаёт их языковой модели как дополнительный контекст. Так модель генерирует более точный и актуальный ответ. Векторная база здесь — ключевой мост между сырой информацией и контекстным пониманием: она превращает неструктурированные данные в семантически значимое пространство знаний. Хранилище делает это за счёт векторного индекса — структуры, которая поддерживает быстрый поиск в многомерном пространстве и почти мгновенное извлечение похожих фрагментов.
| Бэкенд | Ключевые особенности | Когда подходит |
|---|---|---|
| Amazon OpenSearch Service | Высокая скорость за счёт данных в памяти, managed cluster и serverless, k-NN поиск, гибридный поиск | Поиск по каталогу товаров, высокие нагрузки, низкая задержка |
| Amazon Aurora PostgreSQL с pgvector | Реляционная база с векторным поиском, индексы IVFFlat и HNSW, метрики L2, cosine, inner product, векторы до 2 000 измерений | Задачи, где нужна реляционная модель и гибкость индексов |
| Amazon S3 Vectors | Нативная поддержка векторов в объектном хранилище, суb-секундная задержка, снижение расходов на хранение до 90% | Большие объёмы с приоритетом стоимости |
Первый бэкенд — Amazon OpenSearch Service. Он даёт высокую скорость за счёт данных в памяти, поддерживает многомерные векторные эмбеддинги в вариантах managed cluster и serverless, а также k-NN поиск и гибридный поиск, который сочетает лексический и векторный подходы. Bedrock Knowledge Bases работает и с Amazon OpenSearch Managed Clusters, и с Amazon OpenSearch Serverless. Второй вариант — Amazon Aurora PostgreSQL с pgvector. Это сочетание реляционной базы Amazon Aurora с функцией векторного поиска pgvector. Поддерживаются несколько методов индексации (IVFFlat и HNSW), разные метрики расстояния (L2, cosine, inner product) и векторы до 2 000 измерений в одинарной точности. Третий — Amazon S3 Vectors, объектное хранилище AWS с нативной поддержкой векторов. Оно рассчитано на экономичное хранение и запросы эмбеддингов в масштабе, даёт суb-секундную задержку при поиске похожих векторов и снижает расходы на хранение векторов до 90% по сравнению с традиционными векторными базами.
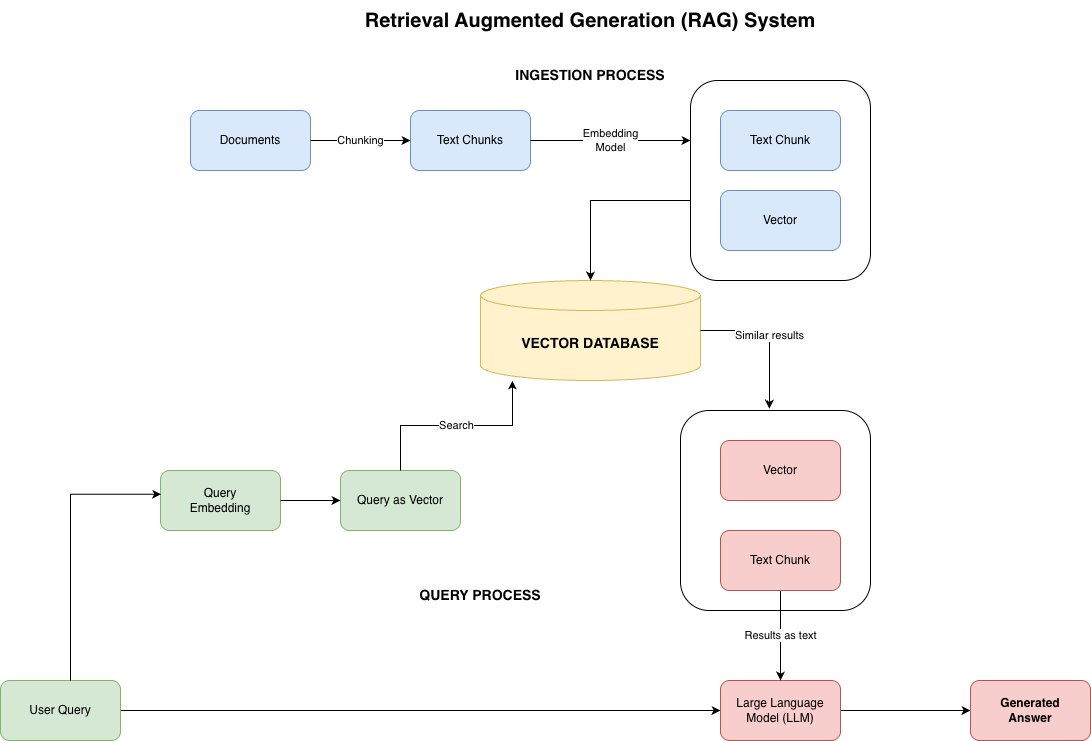
Чтобы показать разницу на практике, AWS разбирает три сценария RAG с разными требованиями к задержке, стоимости и поиску. Первый — поиск по каталогу товаров. Ecommerce-платформам нужно, чтобы покупатель находил нужное среди тысяч позиций. Инструмент поиска должен понимать запросы на естественном языке, выдерживать тысячи одновременных запросов в пиковые периоды и сохранять низкую задержку. Для этого сценария лучше подходит Amazon OpenSearch Serverless: он объединяет семантическое понимание с классическим совпадением по ключевым словам через гибридный поиск. Остальные два сценария в источнике не раскрыты так же подробно, но сам принцип выбора остаётся: для приложений с жёсткими требованиями к скорости и гибридному поиску берут OpenSearch, для тех, где важна реляционная модель и гибкость индексов, — Aurora PostgreSQL с pgvector, а для больших объёмов с приоритетом цены — S3 Vectors.
Контекст для читателя, который впервые слышит о теме: векторные базы стали отдельным классом инфраструктуры вместе с ростом RAG-приложений. До этого поиск по смыслу часто строили на отдельных движках, а хранение эмбеддингов требовало специализированных решений с высокой стоимостью. AWS предлагает не одну базу, а портфель из нескольких сервисов под разные задачи — от управляемых кластеров до объектного хранилища с векторной поддержкой. Такой подход позволяет не переплачивать за скорость там, где она не нужна, и наоборот. Для команд, которые собирают RAG на Bedrock, это означает, что архитектурное решение о хранилище стоит принимать до запуска в продакшен, а не после первых проблем с задержкой или счётом за инфраструктуру.