Amazon SageMaker представила сценарий serverless-дообучения открытой модели Qwen3-8B для автоматической разметки товаров в розничных каталогах. Задача типовая для e-commerce: названия, описания и категории товаров приходят из разных источников и меняются постоянно, а поиску, рекомендациям и навигации нужны согласованные теги. Вручную проставлять атрибуты для тысяч SKU долго и сложно удержать единообразие.
Универсальная frontier-модель способна генерировать теги через промпт-инжиниринг, но у конвейера разметки высокая нагрузка и узкая цель: возвращать нужные атрибуты в нужной схеме, стабильно. Когда таксономия стабильна, а результат можно оценить программно, дообучение небольшой открытой модели оказывается более подходящим. Модель учится схеме напрямую, а разработчик управляет балансом между пропущенными и лишними тегами. Заодно не приходится платить за широкие возможности, которые в этом сценарии не нужны на каждом запросе.
| Параметр | Serverless model customization | SageMaker Training Jobs |
|---|---|---|
| Управление ресурсами | SageMaker выбирает и освобождает ресурсы автоматически | Заказчик выбирает GPU-инстансы |
| Обучающий образ | Кастомный образ не требуется для SFT и RLVR | Используются кастомные обучающие образы |
| Инструменты | Amazon SageMaker Python SDK v3, трейнеры SFTTrainer и RLVRTrainer | Пример из amazon-sagemaker-examples с Qwen3-8B |
В примере AWS модель Qwen3-8B сначала проходит supervised fine-tuning (SFT) — обучение с учителем на подготовленных парах «промпт — целевой ответ». Затем поведение оптимизируется методом reinforcement learning with verifiable rewards (RLVR) с алгоритмом Group Relative Policy Optimization (GRPO). RLVR отличается тем, что награда вычисляется детерминированно: если ответ можно проверить программно, модель получает объективную оценку, а не суждение другой модели. GRPO, в свою очередь, сравнивает варианты ответов внутри группы и подстраивает политику модели относительно них.
Схема обучения двухэтапная: supervised fine-tuning учит модель формату тегов, RLVR с GRPO оптимизирует поведение по детерминированной награде.
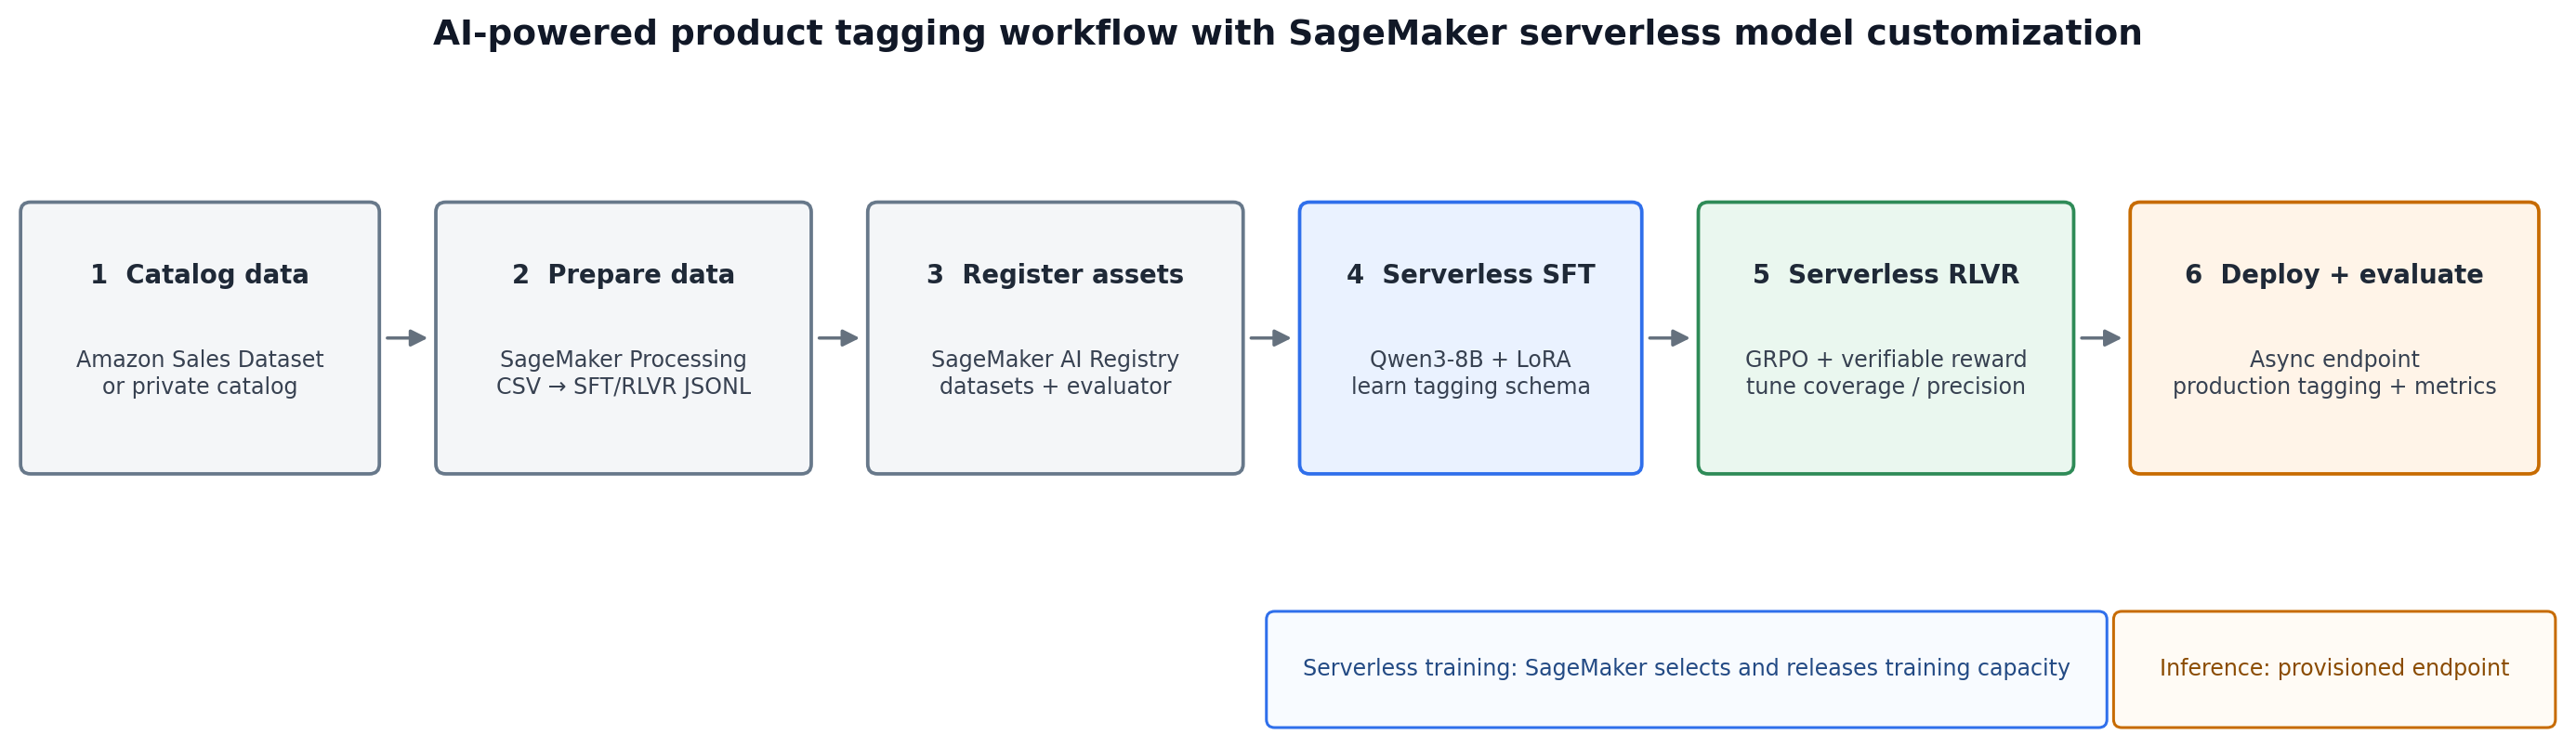
Ключевое отличие от более раннего примера с Qwen3-8B в репозитории amazon-sagemaker-examples — в способе управления обучением. Там использовались Amazon SageMaker Training Jobs с выбранными заказчиком GPU-инстансами и кастомными обучающими образами. Здесь применяется Amazon SageMaker Python SDK v3 с serverless-трейнерами SFTTrainer и RLVRTrainer. Если конфигурация вычислений не передана, SageMaker сам выбирает и освобождает ресурсы под задачу дообучения. Serverless SFT и RLVR не требуют кастомного обучающего образа — он нужен только если вы собираете и хостите образ vLLM для инференса.
Инференс вынесен отдельно: оптимизированная модель разворачивается на Amazon SageMaker Asynchronous Inference для пакетного обогащения каталога. Здесь «serverless» относится только к обучению — асинхронный эндпоинт использует provisioned-инстанс ml.g6.2xlarge. Такой разрыв логичен: обучение эпизодическое, а разметка каталога идёт пакетами, и асинхронный режим подходит для задач, где ответ не нужен мгновенно.
Конвейер разделён на три части: подготовка данных, serverless-дообучение и инференс. Данные один раз преобразуются в версионированные артефакты, SFT учит модель схеме тегирования, RLVR оптимизирует поведение по детерминированной награде, после чего финальный пакет модели хостится для инференса. В примере используется публичный Amazon Sales Dataset с Kaggle — более 1000 записей с полями product_id, product_name, category, about_product, ценой, рейтингами, отзывами и ссылками. Для разметки берутся поля, обращённые к каталогу: название, путь категории и описание. Преобразование выполняется как задача Amazon SageMaker Processing, чтобы подготовку данных можно было повторять и проверять.
Для запуска нужны права Amazon SageMaker ИИ на управление serverless-задачами, датасетами и оценщиками ИИ Registry, группами пакетов моделей, эндпоинтами и асинхронным инференсом, а также iam:PassRole. Требуется доступ к Amazon S3 для чтения и записи каталога, обучающих данных, артефактов модели и результатов асинхронного инференса. Доступ к Amazon ECR нужен только при сборке образа vLLM. Также нужны регион AWS и комбинация модели и метода, поддерживаемые для Qwen3-8B SFT и RLVR, и достаточная квота на хостинг ml.g6.2xlarge. Локально требуются Python 3.11+, AWS CLI v2, pandas, Amazon SageMaker Python SDK v3 и Docker для сборки образа vLLM. Аутентификацию рекомендуется строить на AWS IAM Identity Center или другом потоке краткоживущих учётных данных, без root-доступа и долгоживущих ключей.
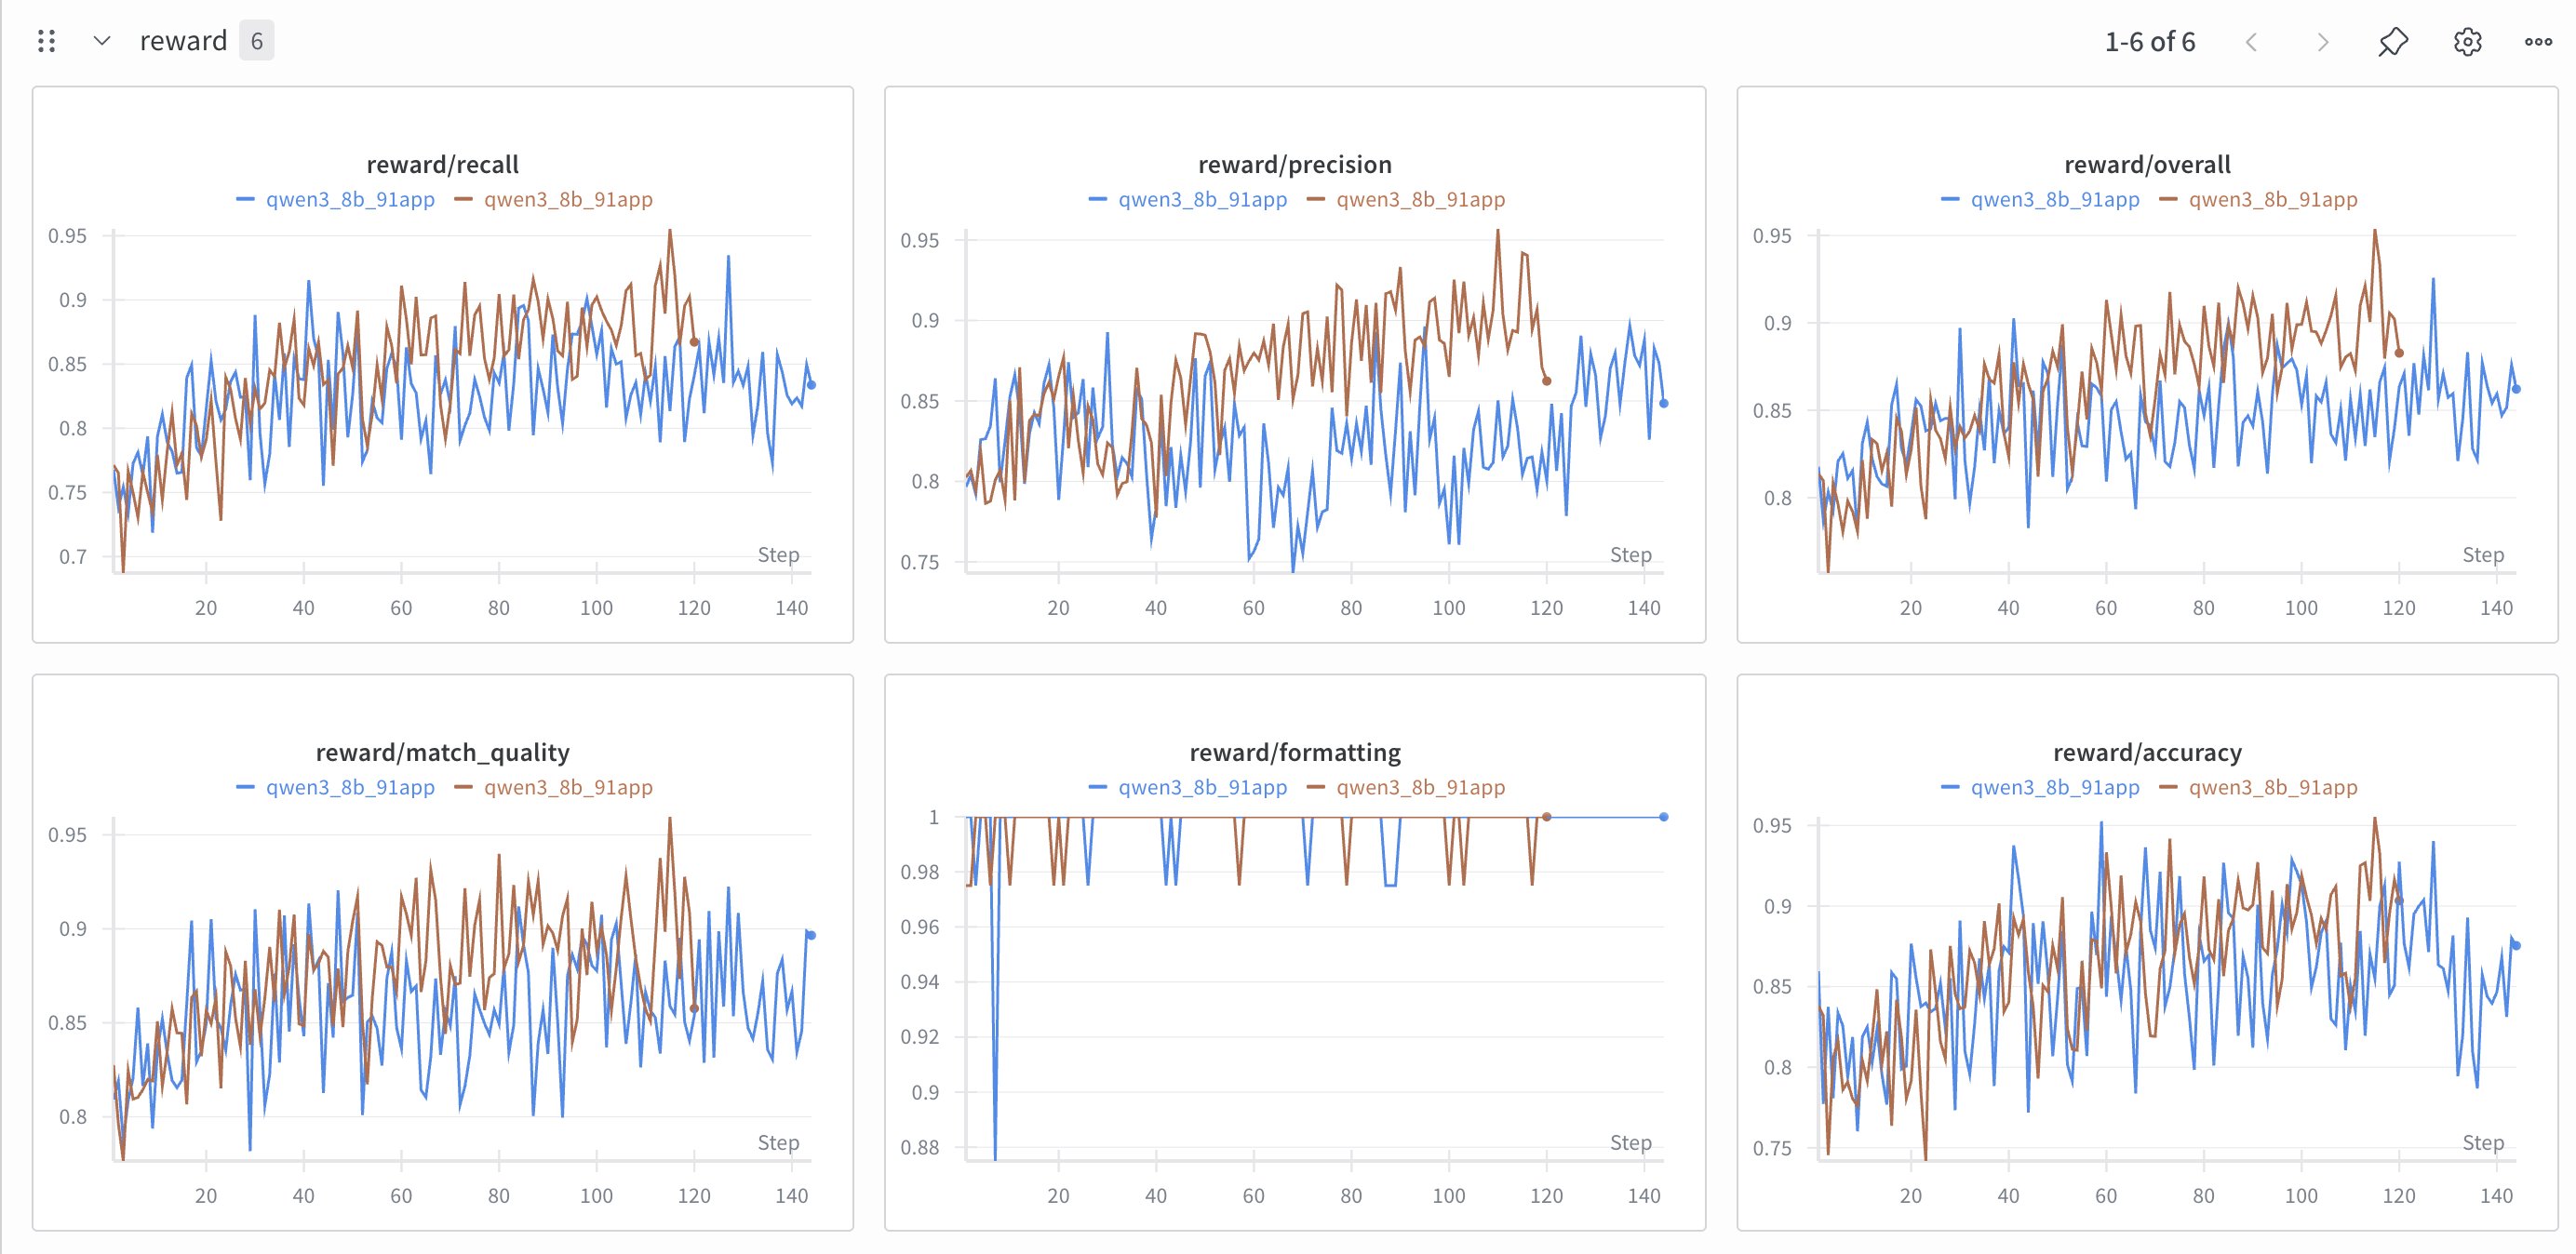
Практический смысл сценария в том, что он показывает, как перенести разметку каталога с универсальной модели на дообученную открытую. Это снижает стоимость на каждом запросе и делает поведение предсказуемым, если таксономия стабильна. Ограничение тоже понятно: подход заточен под узкую задачу с проверяемой наградой, и при частой смене схемы тегирования выгода от дообучения уменьшается.