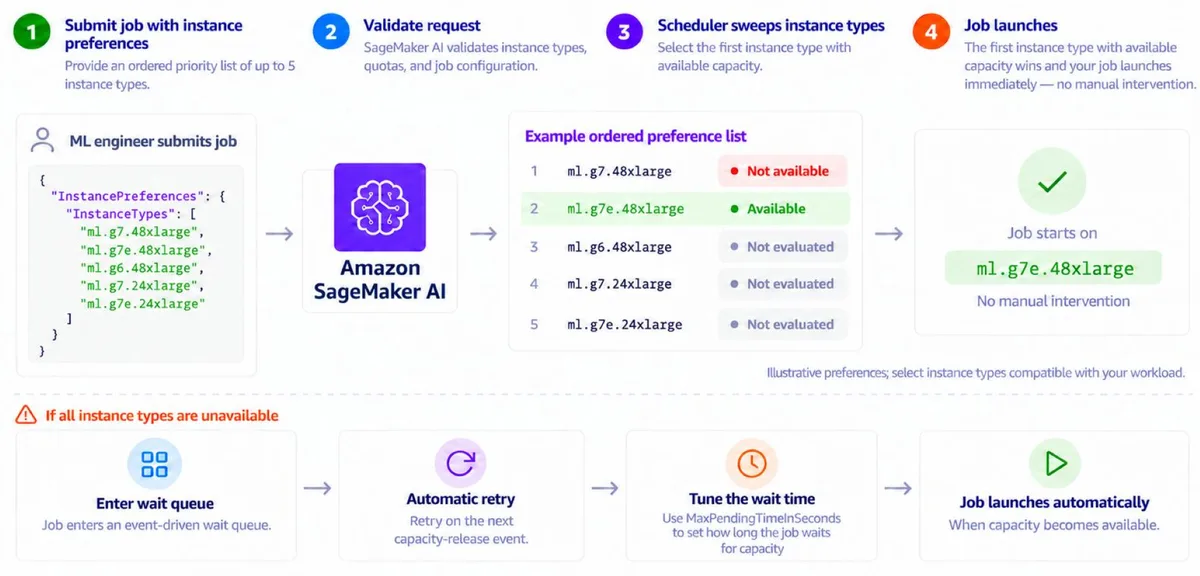
Дефицит GPU в пиковые периоды остаётся одной из главных операционных проблем при обучении и дообучении моделей. Если задача привязана к одному типу инстанса, а его ёмкость занята, у команды два пути: ждать или вручную перебирать альтернативы. Amazon предложила третий вариант — Instance preference lists для Amazon SageMaker ИИ Training Jobs и Processing Jobs. При создании задачи указывается упорядоченный список до пяти типов инстансов, и платформа сама выбирает первый, где есть свободная ёмкость.
Механика простая. Пользователь отправляет задание со списком предпочтений. SageMaker ИИ проверяет конфигурацию и список на соответствие поддерживаемым типам и лимитам ресурсов. Планировщик делает один проход по списку в памяти и находит первый тип с доступной ёмкостью. Этот инстанс выделяется немедленно, и задача стартует. Если ни один из перечисленных типов не доступен, срабатывает механизм повторной попытки. Всё это происходит одного API-вызова, без внешних скриптов и ручного вмешательства.
| Параметр | Значение |
|---|---|
| Сервисы | SageMaker AI Training Jobs, SageMaker Processing Jobs |
| Максимум типов в списке | 5 |
| Порядок выбора | По приоритету, первый доступный |
| Совместимость с резервированием | Flexible Training Plans |
| Механизм при отсутствии ёмкости | Повторная попытка |
Раньше команды решали проблему самостоятельно: писали скрипты, которые опрашивали статус задания, отменяли зависшие запросы и перезапускали их на других типах инстансов. Такие обходные пути плохо интегрировались с резервированием ёмкости, например Flexible Training Plans, и требовали постоянного сопровождения. Особенно болезненно это для ночных конвейеров переобучения и задач обработки данных: если в 2 часа ночи задание падало с ошибкой InsufficientCapacityError, это сдвигало весь график. Новая функция снимает необходимость в таких скриптах.
В одном задании можно перечислить до пяти типов инстансов в порядке приоритета.
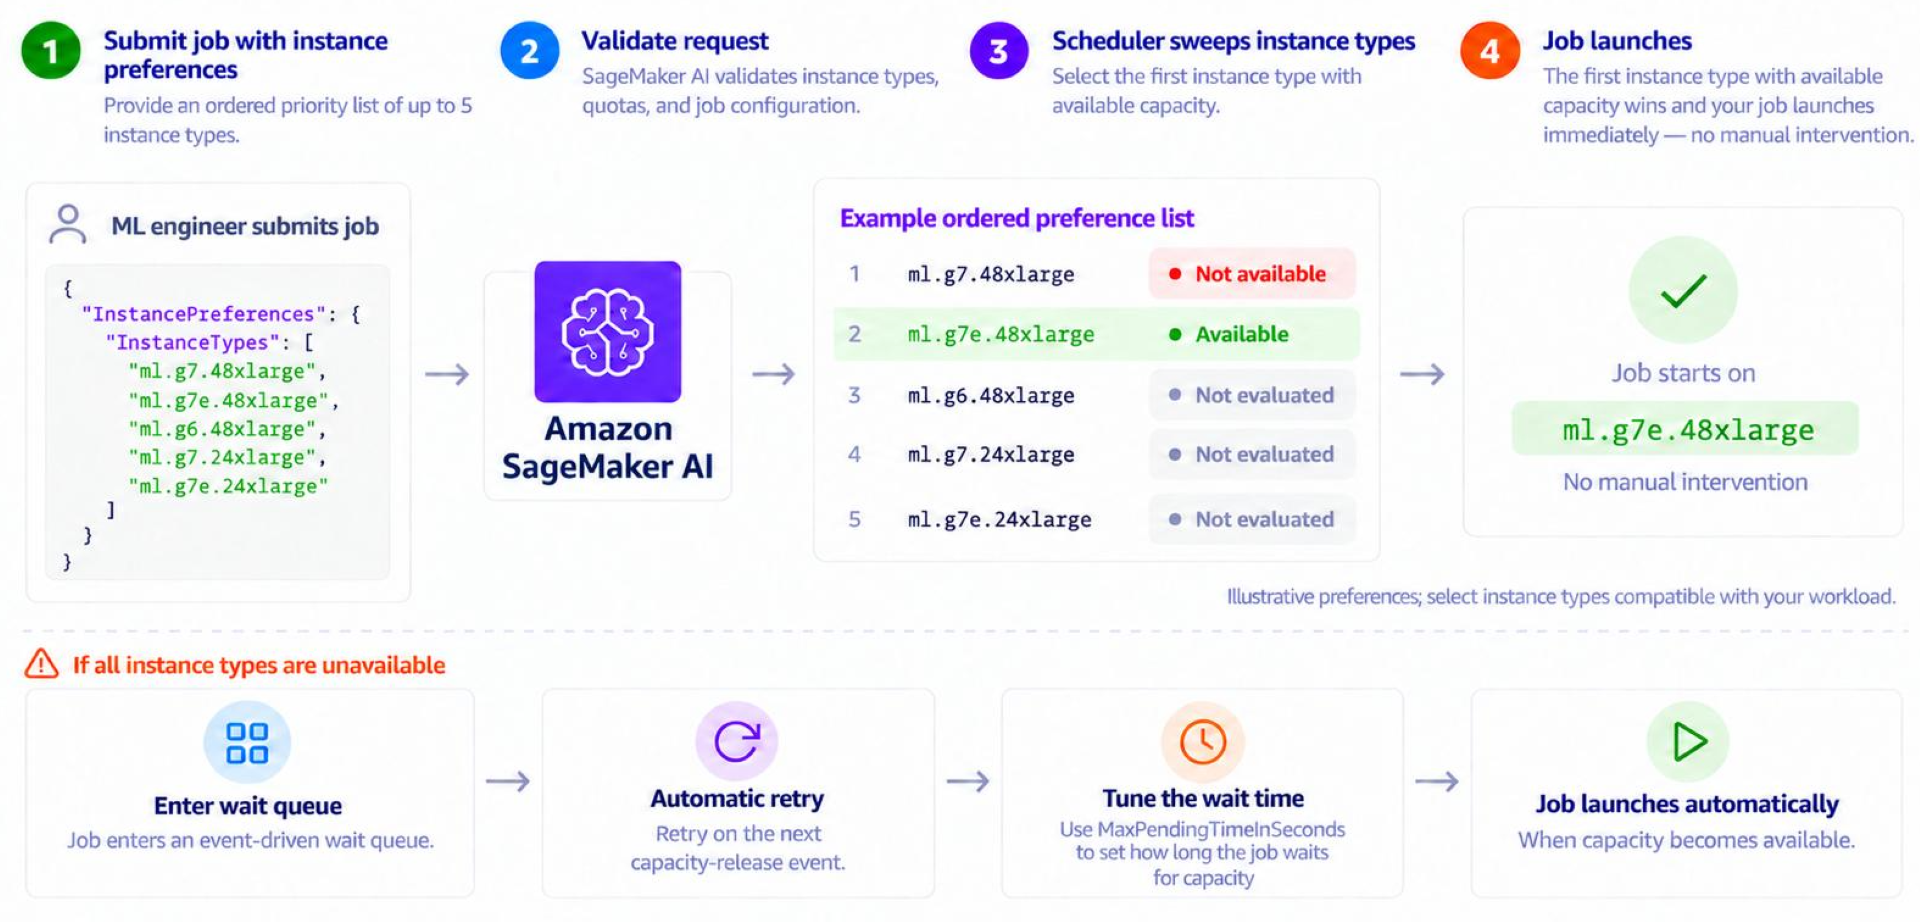
Списки предпочтений учитывают и reserved capacity. Если у команды есть Flexible Training Plan, планировщик сначала проверит зарезервированный пул, а затем, если он исчерпан, перейдёт к альтернативным типам на on-demand. Это позволяет выразить приоритет явно: например, сначала попытаться использовать оплаченный резерв, а потом — любой доступный GPU из списка. Раньше для этого приходилось перезапускать задание вручную.
Для индустрии это шаг к более гибкому управлению GPU-ресурсами. Многие тренировочные нагрузки выполняются одинаково хорошо на двух-трёх семействах инстансов, но жёсткая привязка к одному типу создаёт хрупкость. Автоматический выбор из списка повышает утилизацию доступной ёмкости и сокращает время ожидания. В условиях, когда спрос на GPU для ИИ растёт, а предложение ограничено, такие механизмы становятся не удобством, а необходимостью. Amazon не раскрывает, насколько быстрее стартуют задачи в среднем, но сама логика — один вызов вместо серии ручных попыток — экономит инженерные часы и снижает операционную нагрузку.