Проблема, которую решает AWS, лежит в основе почти любого проекта по промышленной безопасности с компьютерным зрением. Чтобы модель надёжно находила человека рядом с техникой, нужны тысячи, а иногда и миллионы размеченных изображений. Но самые опасные сценарии — рабочий в слепой зоне, ребёнок у движущегося механизма, человек на путях — почти не встречаются в естественных датасетах. Это создаёт сильный дисбаланс классов: модель видит много безопасных ситуаций и мало тех, ради которых её вообще обучают.
Собрать такие данные вручную сложно по трём причинам. Первая — этика и безопасность: ставить людей, тем более детей, рядом с работающей техникой ради фотографий недопустимо. Вторая — редкость самих событий: чем опаснее сценарий, тем меньше его в реальных архивах. Третья — цена: по оценке AWS, сбор и разметка одного изображения обходятся примерно в $3–5, а команда аннотаторов обрабатывает порядка двух тысяч снимков в день. При этом модели должны работать на edge-устройствах — камерах на тракторах, погрузчиках или вагонах, где размер архитектуры ограничен и каждый обучающий пример на счету.
| Этап | Инструмент | Что делает |
|---|---|---|
| Генерация изображений | Qwen-Image-Edit-2509 на Amazon SageMaker AI | Вставляет синтетических людей в реальные снимки техники, сохраняя фон, свет и масштаб |
| Автоматическая разметка | Amazon Rekognition DetectLabels API | Строит bounding box вокруг вставленных людей с порогом уверенности 80% |
AWS предлагает не собирать такие кадры, а синтезировать их. Пайплайн состоит из двух этапов. На первом диффузионная модель Qwen-Image-Edit-2509, развёрнутая на Amazon SageMaker ИИ на инстансе ml.g5.12xlarge с четырьмя GPU NVIDIA A10G и 96 ГБ видеопамяти, вставляет синтетических людей в реальные снимки техники. Модель получает структурированный промпт: кого вставить, куда именно — на пути, на путях, на технике, свисающим с края — и какие ограничения соблюдать, чтобы не искажать фон и сохранять резкость. Ключевое отличие от генерации сцен с нуля: редактируются реальные изображения, поэтому фон, освещение и масштаб остаются достоверными, а уже существующая разметка техники не теряет смысла. Такой подход снижает domain gap — падение качества, которое возникает, когда модель, обученная на полностью синтетических сценах, попадает на реальные кадры.
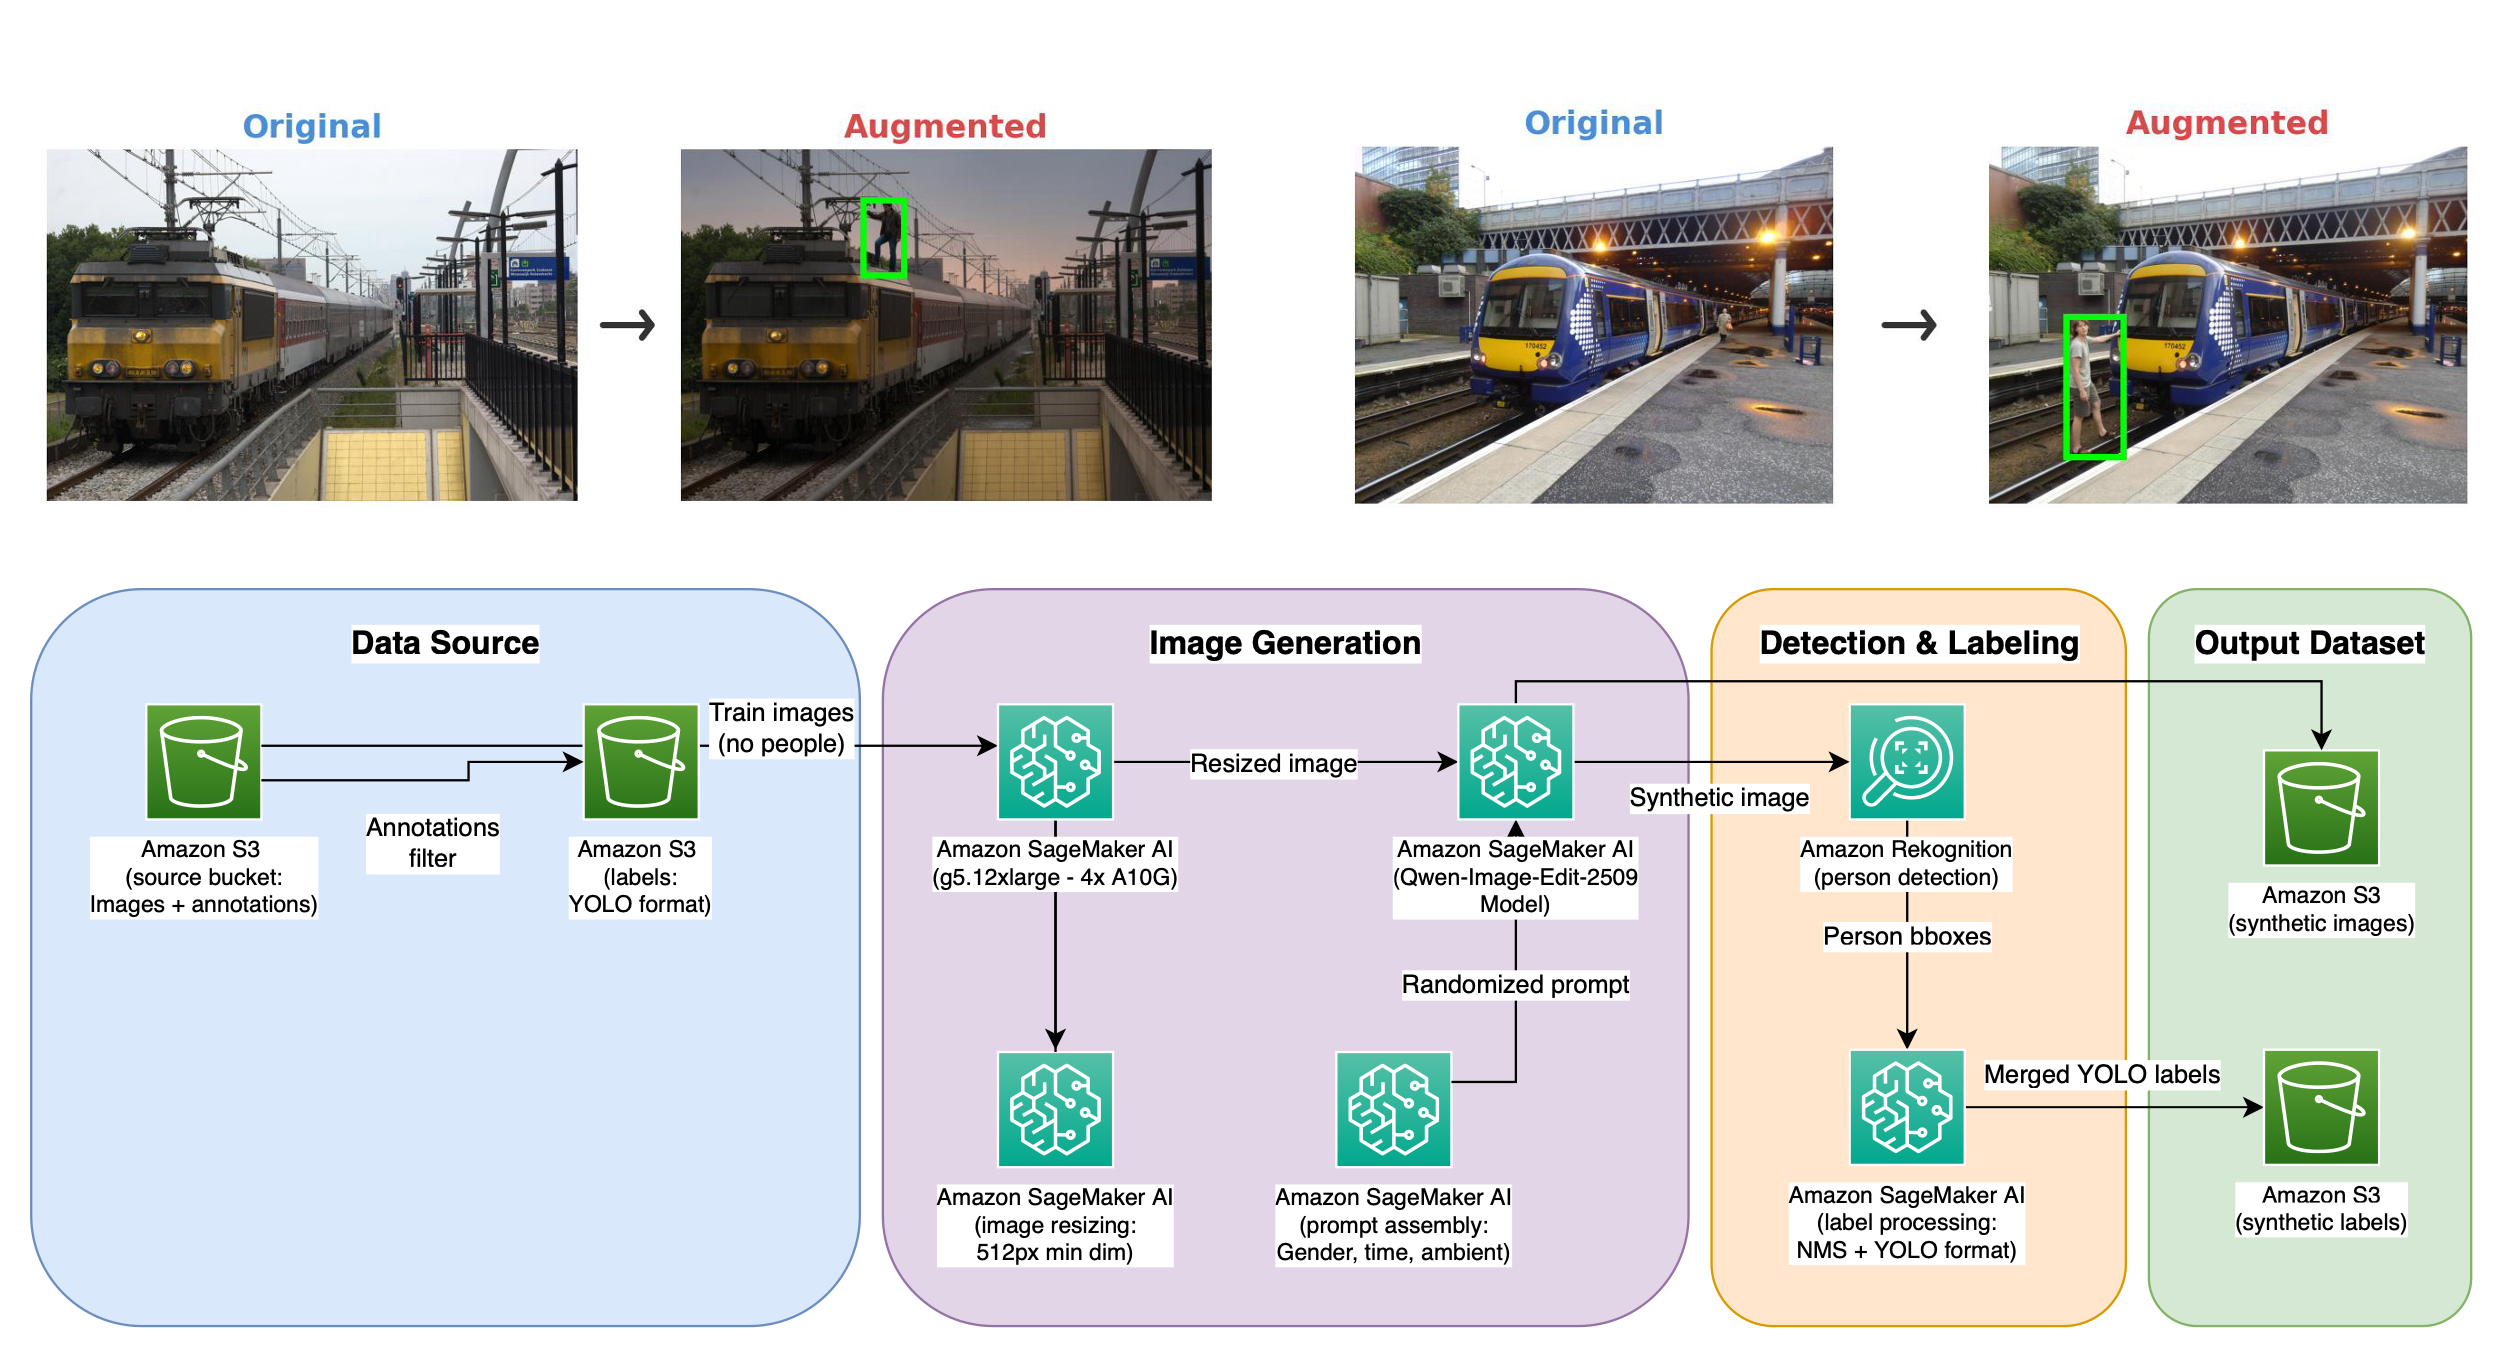
На втором этапе каждое сгенерированное изображение проходит через Amazon Rekognition DetectLabels API с порогом уверенности 80%. API автоматически строит bounding box вокруг вставленных людей, а дубликаты рамок отсекаются. Ручной аннотатор в этом процессе не участвует. По результатам экспериментов AWS, mAP50 для детекции людей выросла до 160% — без разметки вручную и без съёмок людей в опасных позах.
Для отраслей, где уже используются автономная техника и системы контроля, это меняет экономику обучения. Сельское хозяйство, строительство, добыча и производство получают способ пополнять датасет именно теми сценариями, которых в нём не хватает, не тратя деньги на постановочные съёмки. Остаётся вопрос, насколько синтетические вставки покрывают реальное разнообразие: освещение, погода, ракурсы и типы техники в источнике не детализированы. Также не раскрыто, как именно считался прирост mAP50 — на каком наборе и при каком соотношении синтетики и реальных данных. Это ограничивает перенос результата на конкретный парк техники без собственной проверки.