Организации, которые ежедневно обрабатывают тысячи сканированных документов — медицинских форм, страховых заявлений, финансовых отчётов, — сталкиваются с одной и той же задачей: перед передачей третьим лицам или дальнейшей обработкой из документов нужно удалить персональные данные. Ручное зачёркивание не масштабируется: оно съедает часы сотрудников, допускает ошибки и создаёт комплаенс-риски. AWS предложила серверный конвейер, который автоматизирует этот процесс на базе Amazon Bedrock Data Automation (BDA), AWS Step Functions и AWS Lambda.
Проблема не только в обнаружении, но и в точности. На одной странице могут встречаться несколько имён, дат и адресов, и лишь часть из них чувствительна для конкретного сценария. Классический подход сочетает оптическое распознавание символов (OCR) с сопоставлением по шаблонам или собственными ML-моделями. У него есть ограничения: он плохо работает на деградировавшем тексте, с трудом выражает бизнес-логику на уровне полей и требует ML-компетенций для создания и переобучения моделей при смене форматов документов.
| Вопрос при проектировании | Требование для сценария |
|---|---|
| Что считать чувствительной информацией? | Имя пациента, дата рождения, домашний адрес, контактные данные |
| Что не считать чувствительным? | Имя врача, даты осмотров, адрес и контакты кабинета, симптомы и медицинские заметки |
| Где это на странице? | Структурированные поля формы, рукописный текст, несколько экземпляров на документе |
| Как удалить? | Определить координаты bounding box, конвертировать PDF в PNG и наложить чёрные прямоугольники в постобработке |
Генеративный ИИ меняет рамку задачи. Фундаментальные модели интерпретируют страницу целиком — с учётом вёрстки, подписей полей и контекста — и могут определить, кому принадлежит информация, по инструкции на естественном языке, а не через обученную модель сущностей. Amazon Bedrock Data Automation извлекает структурированные данные из неструктурированных документов, изображений, аудио и видео. С помощью кастомного blueprint можно объявить именованные поля, которые нужно извлечь, и описать их обычным текстом. На выходе BDA возвращает содержимое поля, оценку уверенности и координаты bounding box для каждого экземпляра — их используют в постобработке.
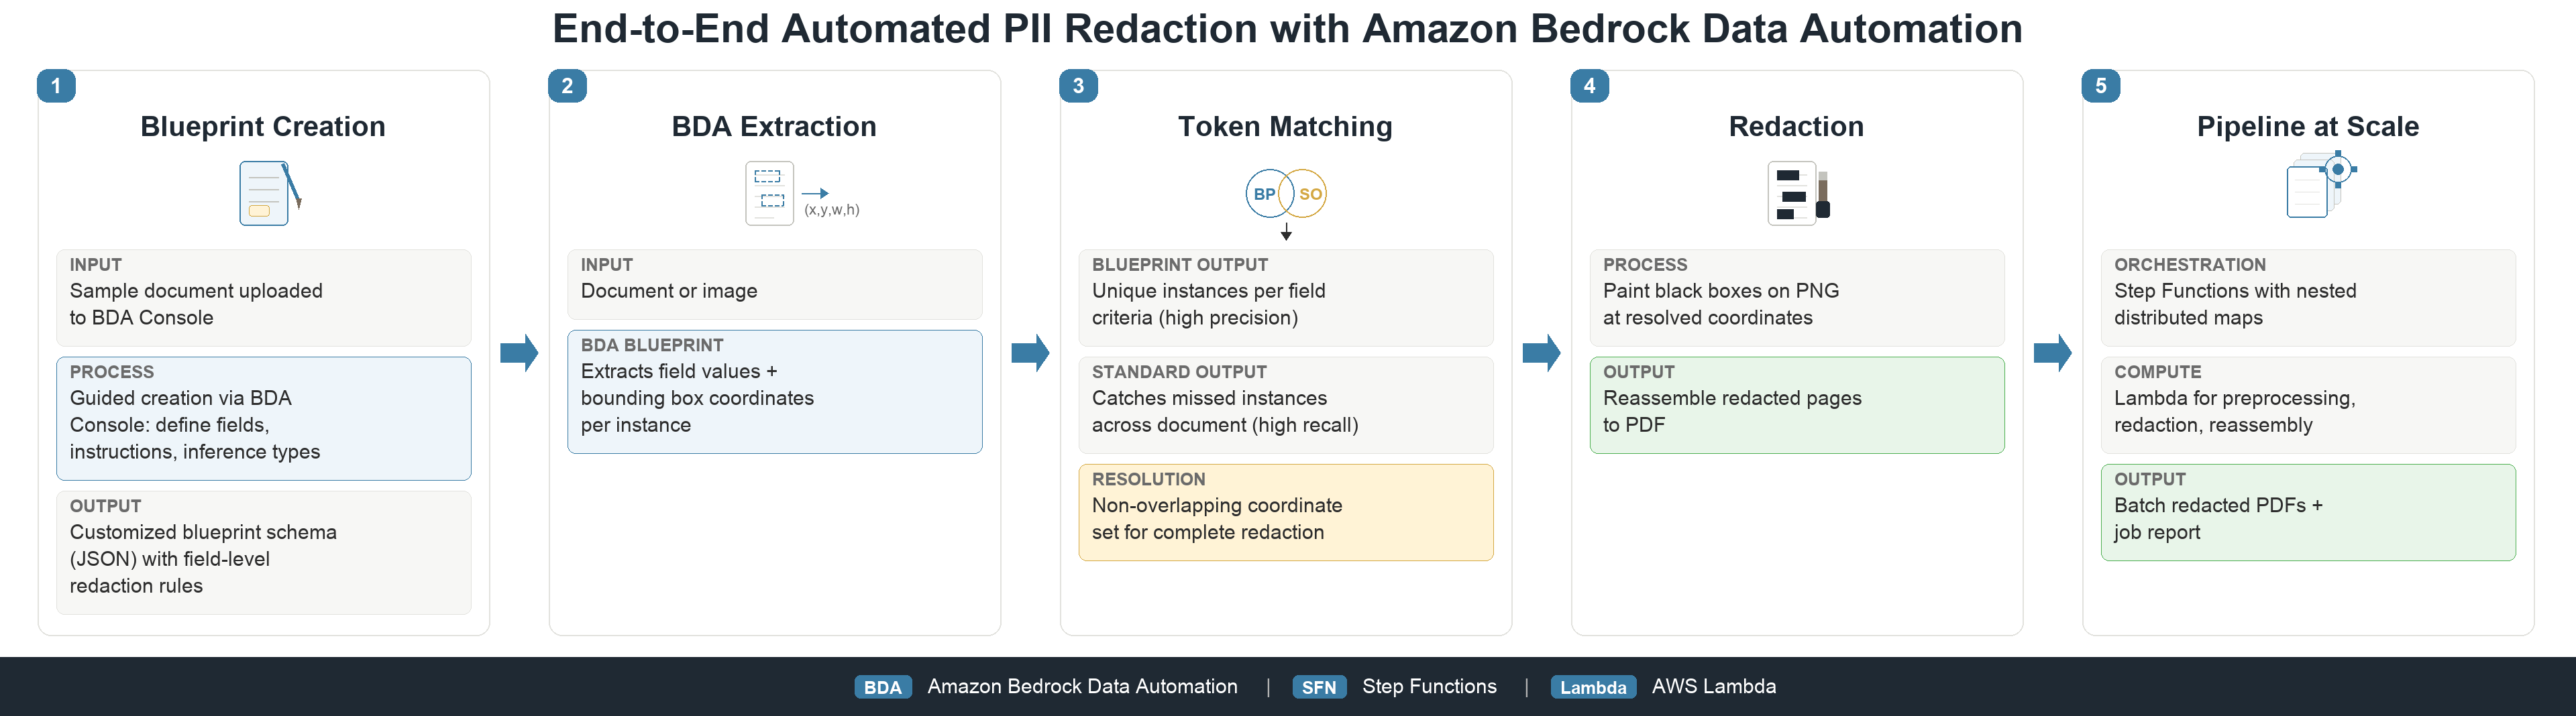
В примере AWS разбирает сценарий обработки Attending Physician Statements перед страховыми выплатами. Нужно удалить имя пациента, дату рождения, домашний адрес и контактные данные. При этом имя врача, даты осмотров, адрес и контакты кабинета, симптомы и медицинские заметки удалять не нужно. Поля разбросаны по структурированным ячейкам формы и рукописному тексту, могут встречаться несколько раз на странице. Удаление реализовано так: BDA находит координаты подходящих полей, PDF конвертируется в PNG, а по координатам накладываются чёрные прямоугольники.
Blueprint создаётся через консоль AWS, AWS CLI или SDK. Консоль предлагает пройти по шагам и сгенерировать схему по образцу документа. Итоговая схема перечисляет поля, доступные для редактирования, их тип данных, краткое описание на естественном языке и применимые преобразования — например, формат даты при inferred inference type. Явный тип вывода (explicit inference type) извлекает данные без ожидаемых преобразований. Показательный случай — поле даты рождения пациента: это дата, но не все даты в документе нужно зачёркивать, например даты приёмов и подписей. Инструкция в blueprint сужает извлечение до целевого поля и привязывает его к пациенту, позволяя BDA отличить дату рождения от даты приёма или подписи даже в сложной вёрстке.
Архитектура состоит из двух частей: кастомного blueprint, который определяет, что именно редактировать, и серверного конвейера, который применяет его в пакетном режиме. Один и тот же конвейер может обслуживать разные сценарии за счёт смены blueprint. Это снижает порог входа: вместо обучения собственных моделей под каждый формат достаточно описать поля и бизнес-правила на естественном языке. Для отраслей с жёсткими требованиями к обработке персональных данных такой подход упрощает аудит — у каждого извлечения есть оценка уверенности и координаты, а значит, результат можно проверить выборочно, не перечитывая документ целиком.