Amazon представила SageMaker HyperPod Inference Gateway — систему маршрутизации запросов к большим языковым моделям, которая учитывает состояние GPU, а не только сетевую нагрузку. Продукт устанавливается как один управляемый аддон EKS в существующую инфраструктуру HyperPod и не требует изменений в серверах моделей или клиентских приложениях. По заявлению AWS, задержка до первого токена снижается до 82%: пользователь чат-бота, ждавший 4,4 секунды, получает ответ менее чем за 800 мс.
Проблема, которую решает шлюз, связана с тем, как Kubernetes по умолчанию распределяет трафик. Алгоритмы round-robin и least-connections не имеют доступа к внутреннему состоянию GPU: они не знают, у каких подов заполнен KV-кэш, какие заняты генерацией длинного контекста, а у каких уже загружен нужный LoRA-адаптер. В результате запросы скапливаются за занятыми подами, тогда как простаивающие мощности остаются неиспользованными. Задержка первого токена в пиковые моменты вырастает до 4 и более секунд, загрузка GPU становится неравномерной, и компаниям приходится закупать лишнее оборудование, чтобы компенсировать перекосы.
| Компонент | Роль |
|---|---|
| Envoy Gateway | Принимает HTTPS-трафик, единая приватная точка входа на кластер |
| Body-Based Router | Извлекает поле модели из запроса и направляет в нужный пул |
| Endpoint Picker | Выбирает под по метрикам Prometheus и взвешенному алгоритму |
Архитектура Inference Gateway двухуровневая и построена на Kubernetes-примитивах. Первый уровень — это шлюз на каждый кластер, устанавливаемый как аддон amazon-sagemaker-hyperpod-inference. В него входят три компонента на базе открытого Gateway API Inference Extension. Envoy Gateway принимает входящий HTTPS-трафик и предоставляет единую приватную точку входа. Body-Based Router просматривает тело OpenAI-совместимого запроса, извлекает поле модели и направляет запрос в соответствующий пул — так один шлюз обслуживает несколько моделей. Endpoint Picker работает как слой принятия решений: он собирает метрики Prometheus с каждого пода и по взвешенному алгоритму выбирает лучший бэкенд.
Стандартные балансировщики Kubernetes (round-robin, least-connections) не видят состояние GPU и направляют запросы на занятые поды.
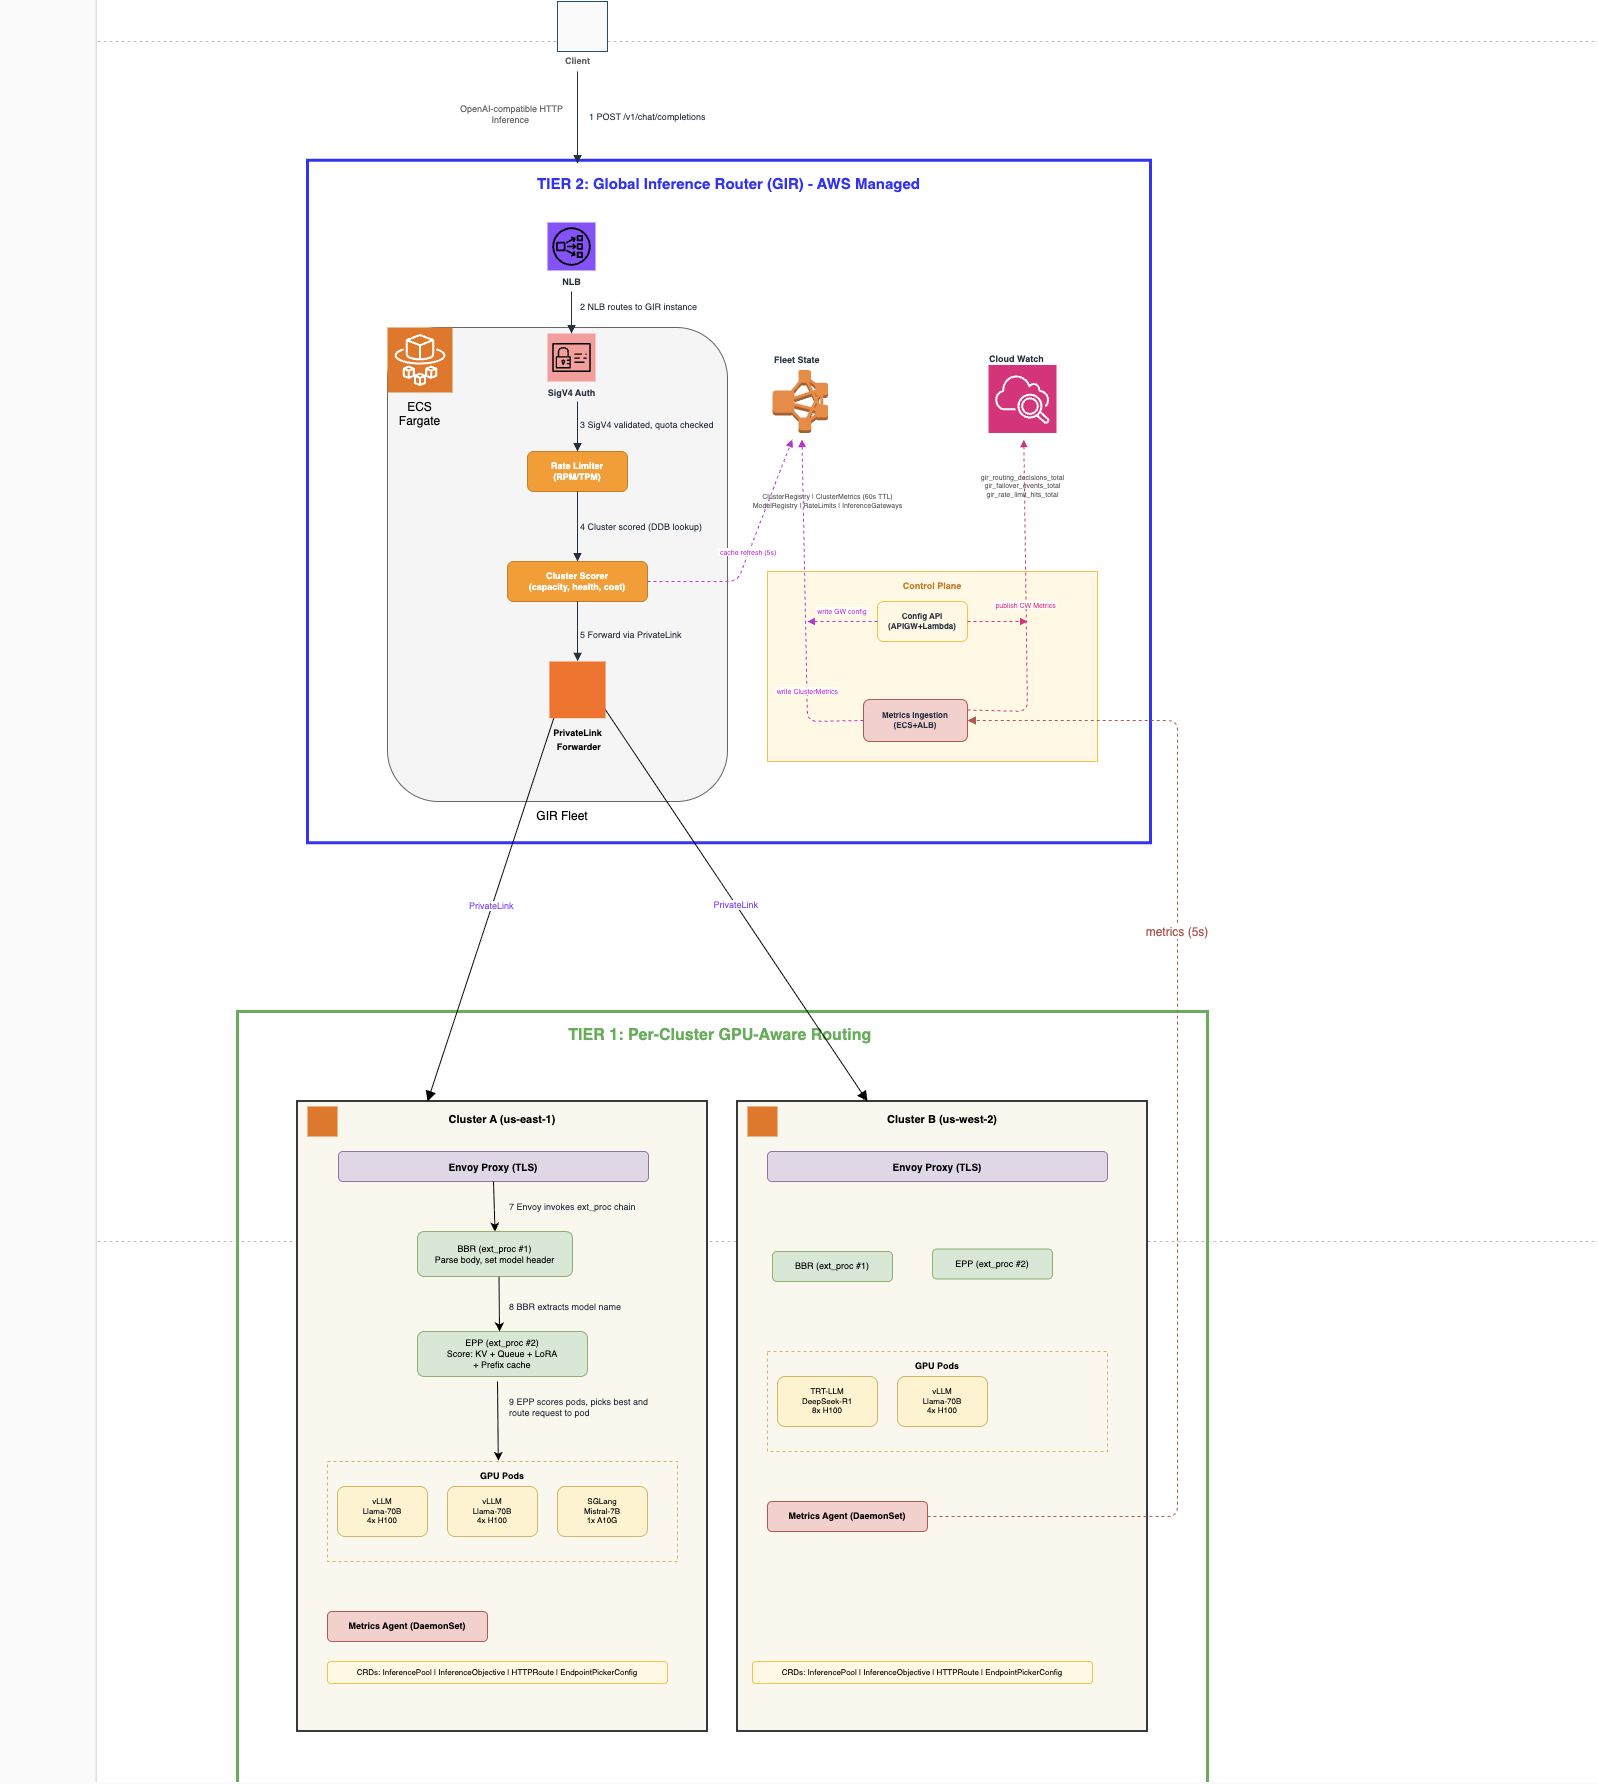
Алгоритм учитывает пять сигналов: заполнение KV-кэша (поды с почти исчерпанной памятью исключаются), глубину очереди запросов, наличие в памяти запрошенного LoRA-адаптера, вероятность попадания в кэш префиксов промпта и число активных запросов. Каждому фактору можно задать вес, чтобы настроить маршрутизацию под конкретную нагрузку — например, чувствительный к задержке чат или оптимизированный по пропускной способности батч-процессинг.
Второй уровень, Global Inference Router, заявлен как будущий релиз. Он добавит координацию между несколькими кластерами и регионами, межкластерный failover, глобальное ограничение скорости запросов и маршрутизацию с учётом стоимости. Этот уровень надстраивается над первым: локальный шлюз каждого кластера продолжает выполнять интеллектуальную маршрутизацию внутри себя.
Запуск занимает около пяти минут. Нужно установить аддон через aws eks create-addon, пометить существующие поды моделей меткой (например, app: vllm-llama), применить декларативный ресурс InferenceGatewayConfig с описанием моделей и параметров маршрутизации и отправлять запросы на стандартный OpenAI-совместимый эндпоинт. Никаких сайдкаров, service mesh, изменений в SDK или подписи SigV4 для трафика инференса не требуется — обычный HTTP со схемой OpenAI.
Для рынка это шаг в сторону более плотной утилизации дорогих GPU. Компании, разворачивающие LLM на кластерах, часто переплачивают за избыточные мощности именно из-за неравномерной загрузки. Инструмент от AWS встраивается в существующий стек HyperPod и EKS, что снижает порог внедрения по сравнению с отдельными системами балансировки. Ограничение — привязка к инфраструктуре Amazon: шлюз работает на HyperPod и EKS, а глобальная координация между регионами пока только обещана.