Распределённое обучение больших моделей на десятках GPU редко обходится без сбоев: сетевые разрывы, ошибки памяти, исключения в коде или инфраструктурные события рано или поздно выводят из строя хотя бы одного воркера. Один сбой GPU запускает цепочку: таймауты NVIDIA Collective Communication Library (NCCL) распространяются на здоровые узлы, поды падают и перезапускаются несинхронно, а кластер сжигает дорогие GPU-часы без прогресса в обучении. Синхронное сохранение чекпоинтов добавляет вторую причину простоя: каждая запись блокирует все ранги на I/O, что на кластерах из этого обзора занимало до 40% общего времени работы.
NVIDIA Resiliency Extension (NVRx) — это pip-устанавливаемый Python-слой (pip install nvidia-resiliency-ext), который добавляет примитивы отказоустойчивости в PyTorch без кастомных ядер, форка PyTorch или перекомпиляции. Примитивы встраиваются в существующий скрипт FSDP как обычные импорты, а модель и код обучения остаются нетронутыми. Каждый примитив можно внедрять независимо. В материале рассмотрены три функции: асинхронный чекпоинтинг, in-process restart и ft_launcher (in-job restart).
| Слой восстановления | Класс сбоев | Механизм |
|---|---|---|
| In-process restart | Мягкие сбои: исключения, зависания NCCL | inprocess.Wrapper перезапускает функцию train без перезапуска процесса |
| ft_launcher | Жёсткие сбои: SIGKILL, OOM-kill, зависания ОС | Перезапуск воркеров в том же job по heartbeat-таймаутам |
| Оркестратор кластера | Потеря узла | Kubernetes пересоздаёт поды, воркеры переподключаются через DNS |
Асинхронный чекпоинтинг через TorchAsyncCheckpoint заменяет torch.save на async_save(), который передаёт state dict фоновому процессу и сразу возвращает управление. Перед следующим сохранением вызывается finalize_async_save(), чтобы зафиксировать предыдущую запись. В паре с FSDP LOCAL_STATE_DICT каждый ранг пишет свой шард напрямую, без all-gather и без узкого места на нулевом ранге. In-process restart через inprocess.Wrapper оборачивает функцию обучения так, что временный сбой (необработанное исключение или зависание NCCL) не убивает Python-процесс. NVRx прерывает активную process group, выполняет проверки здоровья на каждом ранге (GPU, NVLink, NIC), заново собирает выживших и повторно входит в обёрнутую функцию с последнего чекпоинта. Интерпретатор, аллокатор CUDA и объекты внешней области видимости сохраняются. Этот слой ловит класс мягких сбоев.
Асинхронный чекпоинтинг TorchAsyncCheckpoint заменяет torch.save на async_save(), убирая блокировку всех рангов на I/O.
Бинарник ft_launcher, лаунчер in-job restart от NVRx, обрабатывает случаи, которые in-process не ловит: SIGKILL, OOM-kill и зависания на уровне ОС. Каждый ранг запускает RankMonitorClient. Лаунчер сверяет heartbeat с явными таймаутами, заданными через CLI, и при зависании или смерти убивает выживших, освобождает память GPU и запускает новые воркеры в том же job. Восстановленные воркеры загружаются с последнего чекпоинта. Каждый слой восстановления покрывает свой класс сбоев: in-process для мягких, ft_launcher для жёстких, а оркестратор кластера — для потери узла. Слои независимы, можно выбрать тот, чей охват соответствует вашим режимам отказов.
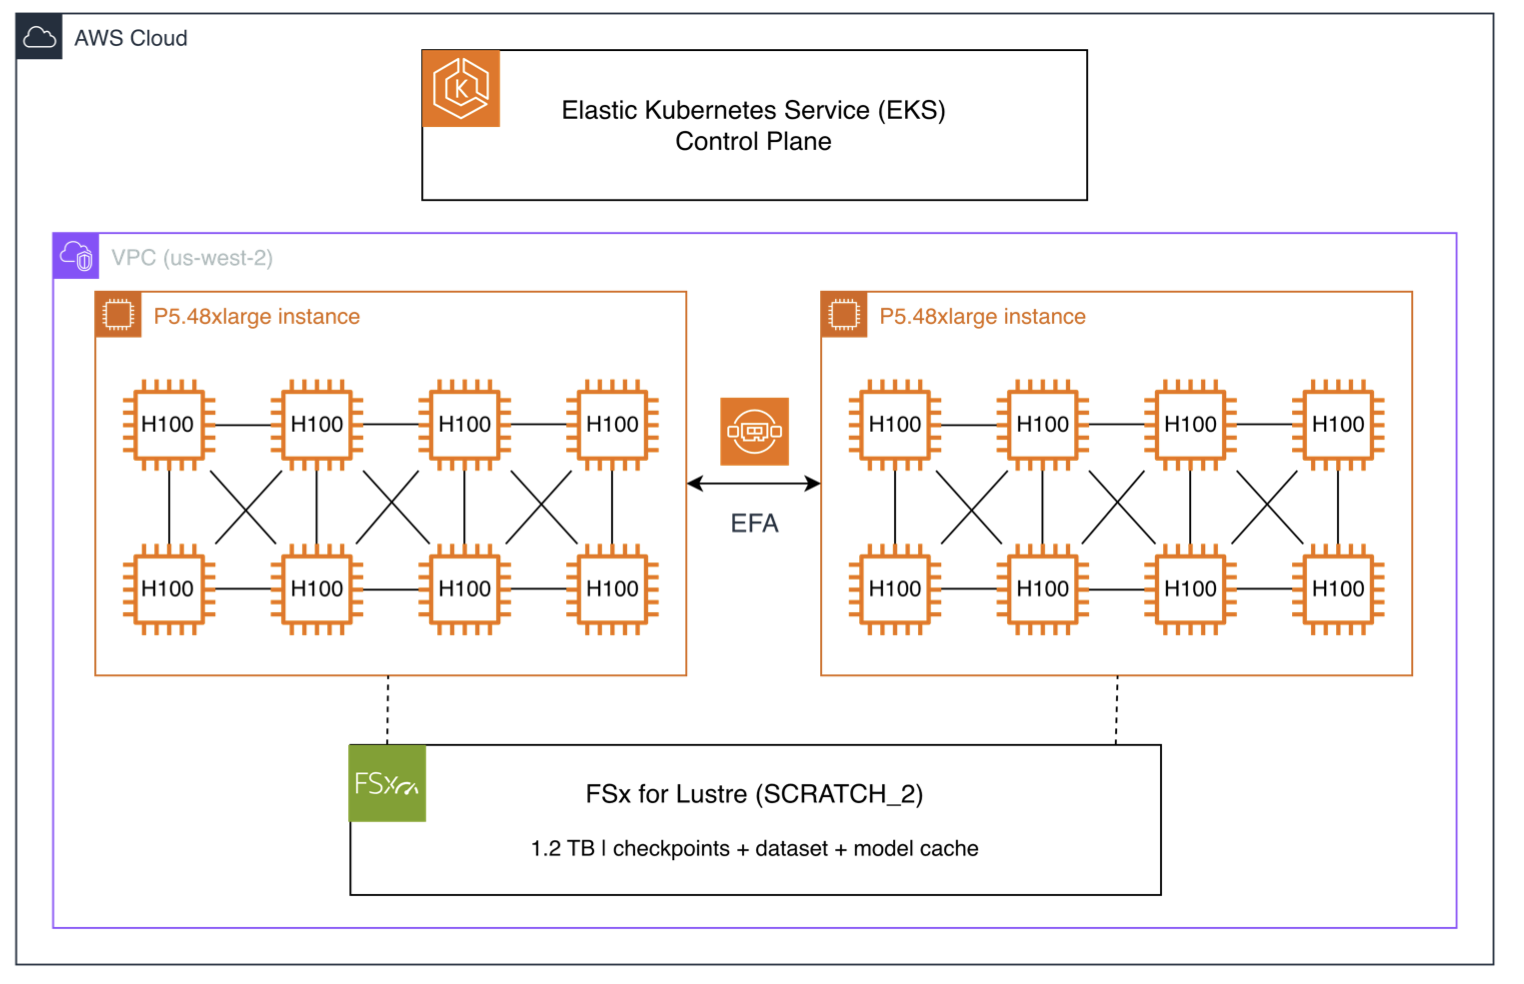
Кластер Amazon EKS — управляемый сервис Kubernetes, который берёт на себя control plane, обновления и доступность API-сервера. В обзоре используются самоуправляемые группы узлов p5.48xlarge, каждый с 8 GPU NVIDIA H100 80 ГБ и 32 сетевыми интерфейсами Elastic Fabric Adapter (EFA). Обучающие поды запускаются как Kubernetes Jobs с headless Services для обнаружения пиров, чтобы воркеры находили друг друга через DNS, а не по жёстко прописанным IP, и заменённые поды могли присоединиться без перенастройки job. Каждый узел предоставляет GPU и адаптеры EFA как расширенные ресурсы через NVIDIA device plugin и EFA device plugin. Планировщик Kubernetes размещает поды на GPU-узлах с помощью node affinity и tolerations, обеспечивая полное выделение 8 GPU на узел. Для хранения чекпоинтов используется Amazon FSx for Lustre (SCRATCH_2, 1,2 ТБ), смонтированная в каждый обучающий под через FSx CSI driver. FSx предоставляет общую файловую систему, куда пишут и асинхронный, и синхронный чекпоинтинг, и откуда восстановленные воркеры читают состояние после сбоя. Размещение FSx в той же зоне доступности, что и GPU-узлы, минимизирует задержку чтения при восстановлении, что важно, поскольку именно загрузка чекпоинта, а не механизм рестарта, определяет время восстановления в масштабе.
Практическая ценность NVRx в том, что она не требует менять модель или переписывать цикл обучения. Достаточно добавить несколько импортов и обернуть функцию train. Это снижает порог внедрения отказоустойчивости для команд, которые уже используют FSDP и EKS. В условиях, когда час аренды узла с 8 H100 стоит дорого, сокращение простоев на десятки процентов даёт прямую экономию. При этом NVRx не заменяет инфраструктурные решения: для потери узла по-прежнему нужен оркестратор кластера, а для эффективного восстановления — быстрая общая файловая система вроде FSx for Lustre.