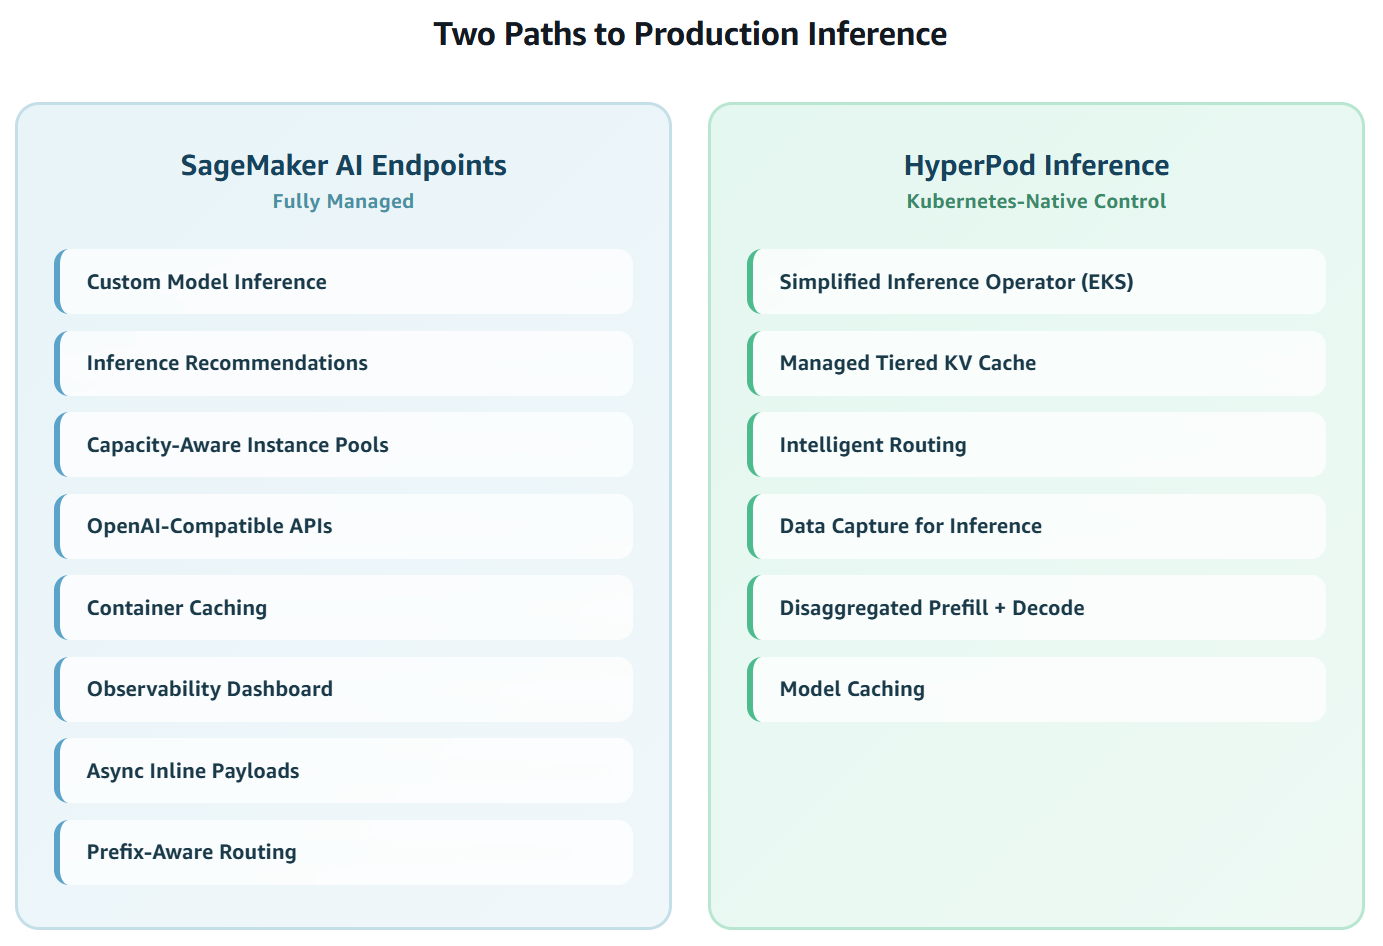
Инференс генеративных моделей устроен сложнее, чем кажется со стороны. Веса моделей занимают десятки и сотни гигабайт, задержка измеряется в токенах в секунду, холодный старт может растягиваться на минуты из-за загрузки контейнеров и весов, а GPU-ёмкость ограничена. Традиционные инструменты мониторинга не показывают сигналы на уровне токенов, которые важны в продакшене. Amazon SageMaker ИИ предлагает два пути развёртывания: управляемые endpoints, где AWS берёт на себя инфраструктуру и операции, и Amazon SageMaker HyperPod Inference для команд, которым нужен Kubernetes-нативный контроль над выделенными GPU-кластерами. За 2026 год компания выпустила 13 новых возможностей этих двух направлений.
Endpoints — более быстрый путь. Клиент приносит модель и определяет цель по производительности: стоимость, задержку или пропускную способность. AWS обеспечивает провижининг GPU, масштабирование и операционный мониторинг. Семь запусков этого года охватывают развёртывание, ёмкость, интеграцию, масштабирование, наблюдаемость и упрощение асинхронных сценариев.
| Параметр | Endpoints | HyperPod Inference |
|---|---|---|
| Инфраструктура | Полностью управляется AWS | Управляемый Kubernetes-стек |
| Цель развёртывания | Консоль, SDK, CLI | kubectl, Terraform, консоль, CLI, SDK |
| Масштабирование | Управляемое авто-масштабирование с CloudWatch | Авто-масштабирование с Karpenter, KEDA, CloudWatch |
| Кастомизация | На уровне контейнера и модели | Доступ на уровне нод, фреймворки и AMI |
| API-протокол | OpenAI-совместимый с SageMaker endpoint | HTTP, gRPC и кастомный балансировщик |
| Для кого | Быстрое развёртывание с минимальными операционными затратами | Kubernetes-ориентированные train-to-serve сценарии в мульти- и гибридных облаках |
Inference recommendations, вышедшие в апреле 2026 года, автоматизируют подбор типа инстанса, сервинг-контейнера и настроек оптимизации. Раньше это занимало две-три недели ручного бенчмаркинга по более чем 1000 комбинациям и требовало экспертизы, которой у большинства команд нет. Теперь клиент указывает модель и цель, а SageMaker выполняет три шага: сужает пространство типов инстансов по архитектуре, размеру и требованиям к памяти; применяет техники под цель — EAGLE 3.0 speculative decoding для пропускной способности, тюнинг ядер для задержки, tensor parallelism по размеру модели; запускает NVIDIA AIPerf на реальной GPU-инфраструктуре со статистически строгой отчётностью по нескольким прогонам. На выходе — SageMaker Model Package с готовыми конфигурациями и метриками: time to first token (TTFT), inter-token latency (ITL), перцентили P50/P90/P99, пропускная способность и прогноз стоимости. В демонстрационном примере оптимизация пропускной способности на GPT-OSS-20B дала 2x токенов в секунду при той же задержке запроса. Генерация рекомендаций не тарифицируется дополнительно; клиенты с ML Reservations могут бенчмаркать на зарезервированной ёмкости без доплаты.
Capacity-aware instance pools, появившиеся в мае 2026 года, решают проблему единственной точки отказа. Раньше endpoint требовал один тип инстанса, и нехватка ёмкости означала отказ до первого запроса. Теперь клиент задаёт приоритизированный список до пяти типов инстансов. SageMaker проходит по нему при создании endpoint, при масштабировании вверх и вниз. При создании пробует первый тип и сразу переключается при недоступности. При scale-out следующий доступный тип поглощает нагрузку. При scale-in фолбэк-инстансы удаляются первыми, чтобы флот возвращался к предпочтительному железу по мере освобождения ёмкости. Метрики CloudWatch с разбивкой по типу инстанса позволяют строить взвешенные политики масштабирования для разнородных флотов. Каждая запись пула может ссылаться на отдельную оптимизированную конфигурацию модели.
HyperPod Inference — второй путь, для команд с Kubernetes-нативными требованиями. Он даёт доступ на уровне нод, выбор фреймворков и AMI, поддерживает HTTP, gRPC и кастомные балансировщики. Среди обновлений этого года — упрощённый оператор, tiered KV cache, disaggregated prefill и decode, а также кэширование моделей. Эти функции снижают задержки и упрощают управление кластерами для train-to-serve сценариев в мульти- и гибридных облаках.
Оба пути поддерживают OpenAI-совместимый API, что упрощает миграцию существующих приложений. Для endpoints доступны также асинхронный инференс с inline payloads, префикс-маршрутизация, кэширование контейнеров и наблюдаемость. В совокупности эти 13 функций закрывают разрыв между исследовательским прототипом и продакшен-нагрузкой: автоматизация подбора конфигураций, устойчивость к дефициту GPU и гибкость развёртывания становятся базовыми ожиданиями от платформы, а не отдельными проектами внутри команды.