Современный поиск всё чаще должен возвращать не одну лучшую ссылку, а осмысленный набор. Запрос «camping gear» подразумевает палатку, спальник, горелку и фонарь, а не десять вариаций четырёхместной палатки. Для этого применяют технику fan-out: широкий запрос разбивается на несколько связанных подзапросов, покрывающих разные интересы пользователя.
Проблема в том, что обучение языковой модели динамической декомпозиции с учётом конкретной базы данных требует огромного бюджета вычислений на этапе инференса. Zero-shot LLM по своей природе — универсальные авторегрессионные предсказатели текста, они не оптимизированы под геометрию конкретного корпуса. Чтобы выдать набор результатов, оптимизирующий свойства уровня множества — разнообразие, покрытие, комплементарность, связность — и при этом остающийся привязанным к фиксированной базе, модели нужны длительные вычисления во время ответа.
| Этап | Что происходит |
|---|---|
| Обучение fan-out модели | RL тренирует модель выдавать подзапросы, согласованные со свойствами, оцениваемыми наградами уровня множества |
| Синтез супервизии | Замороженная fan-out модель офлайн создаёт пары «запрос → целевой набор» без ручной разметки |
| Диффузионный ретривер | Лёгкая модель обучается на этих данных и выполняет fan-out за один проход на инференсе |
Google Research описывает два следствия этого подхода. Первое — paraphrastic collapse: без оптимизации под базу zero-shot LLM часто генерируют избыточные, почти синонимичные запросы. Например, на широкий промпт «Bohemian festival style» стандартная модель может выдать «bohemian festival fashion» и «bohemian festival clothes», упуская отдельные направления вроде fringe jackets, crochet dresses или suede boots. Второе — latency bottleneck: авторегрессионная генерация требует сотен промежуточных chain-of-thought токенов, чтобы спланировать расширение запроса. Для диалогового ИИ это приемлемо, но для поисковой строки, где нужен ответ за доли секунды, такая архитектура создаёт структурный барьер.
Стандартные LLM при декомпозиции запроса страдают от paraphrastic collapse: вместо разных граней темы выдают почти синонимичные подзапросы.
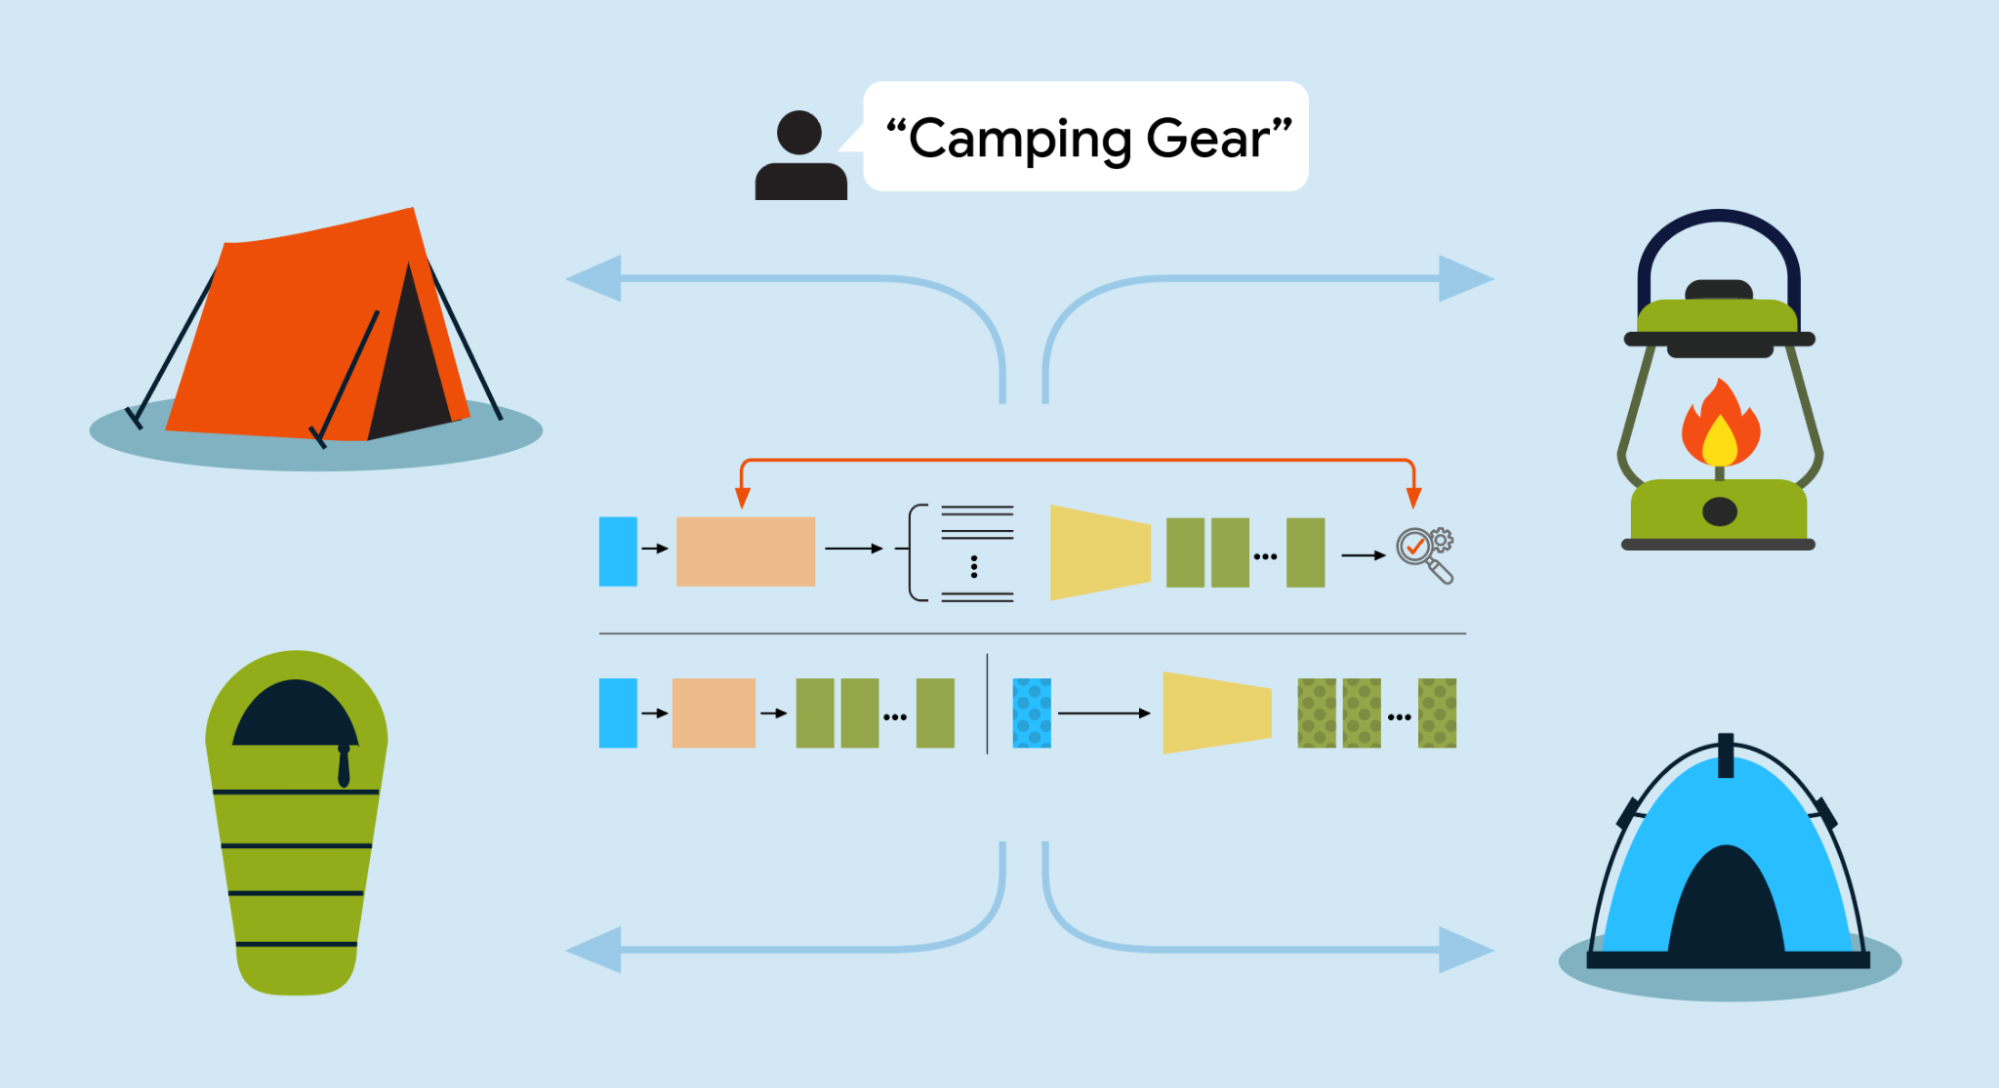
Retrieve-for-Train переносит эту работу в офлайн. Вместо того чтобы заставлять модель разбираться в правилах хорошего поиска при каждом запросе пользователя, фреймворк один раз запускает программу обучения с подкреплением. Она использует систему вознаграждений, которая превращает абстрактные цели — например, «результаты должны быть разнообразными и в наличии» — в точную пошаговую инструкцию. После этого модель может выполнять её мгновенно во время реального поиска.
Пайплайн состоит из трёх шагов. Сначала RL обучает fan-out языковую модель выдавать подзапросы, согласованные со свойствами, которые оцениваются наградами уровня множества: проверяется весь набор результатов целиком, а не каждый по отдельности. Затем замороженная fan-out модель синтезирует пары «запрос → целевой набор» полностью офлайн, без ручной разметки. Наконец, эти данные используются для обучения лёгкого диффузионного ретривера, который на инференсе выполняет fan-out за один проход.
Результат — математически сформулированные свойства уровня множества без накладных расходов на токены рассуждений во время ответа. Для отрасли это означает, что качество подбора связных наборов результатов перестаёт быть привязанным к вычислительному бюджету в момент запроса. Подход перекликается с общим трендом на разделение обучения и инференса: сложные решения принимаются заранее, а в продакшене остаётся быстрая и предсказуемая модель. Для поисковых и рекомендательных систем это может стать способом одновременно повысить релевантность и уложиться в требования по задержке.